Audio8-ASR:语音识别全家桶,云端高精度与端侧低功耗兼得 Audio8-ASR-3B · Audio8-ASR-0.6B · Audio8-ASR-0.1B
2026 年 09 月 10 日
从声音到文字 Audio8-ASR / MODEL FAMILY
语音识别真正走进产品之后,问题从来不只是“模型能不能听懂”。云端服务在意准确率和吞吐,桌面设备在意响应速度,手机端则必须同时面对内存、功耗和隐私。Audio8-ASR 将这些不同约束放进同一个模型家族:用更大的模型追求复杂场景下的识别质量,用更紧凑的模型把语音能力带到普通 CPU 和移动设备。
这不是一条从大到小的简单缩放曲线,而是一组围绕部署边界组织起来的选择。下面从三条产品线出发,梳理它们的定位、技术路线,以及为什么移动端需要单独的一章。
产品线 规模 主要运行环境 适合的任务 语言支持 Audio8-ASR-3B 3B 高性能 GPU 复杂噪声、多语言、高质量转写 19 种语言(中文、英文、德文、日文、法文、韩文、西班牙文、波兰文、意大利文、罗马尼亚文、匈牙利文、捷克文、荷兰文、芬兰文、克罗地亚文、斯洛伐克文、斯洛文尼亚文、爱沙尼亚文、立陶宛文) Audio8-ASR-0.6B 0.6B GPU、工作站与服务器 质量、吞吐与成本的平衡 19 种语言(中文、英文、德文、日文、法文、韩文、西班牙文、波兰文、意大利文、罗马尼亚文、匈牙利文、捷克文、荷兰文、芬兰文、克罗地亚文、斯洛伐克文、斯洛文尼亚文、爱沙尼亚文、立陶宛文) Audio8-ASR-0.1B 0.1B CPU、边缘设备与移动端 资源受限环境下的本地识别 7 种语言(中文、英文、粤语、法文、日文、德文、韩文)
三条产品线,一条清晰的路线 Audio8-ASR 以 3B、0.6B 和 0.1B 三个规模组织产品线。它们共享“把连续声音变成可用文本”的目标,却分别针对质量、成本和设备形态做了取舍。不同运行时和硬件适配属于产品线的落地方式,不改变这三个层级。
从声音到文字:ASR 的技术路线 一段录音进入系统后,首先要被整理成稳定的声学表示;模型再在时间轴上寻找语音内容、停顿和上下文之间的关系,最后生成可读的文字。这个过程既要保留发音细节,也要抑制环境噪声、重复片段和无意义的静音。
大模型的价值通常体现在“难听清”的地方:远场录音里的衰减、多人交谈时的上下文切换、专业名词带来的词汇不确定性,以及长音频中前后内容的关联。更小的模型则把重点放在可预测、可控制的运行时开销上。
因此,Audio8-ASR 的模型差异不应只看参数量。相同的识别任务,在 GPU 上可以换取更大的上下文和更高的吞吐,在 CPU 或手机上则需要让每一次计算都更节制。
Audio8-ASR-3B:把质量留给最复杂的声音 Audio8-ASR-3B 是家族中面向高质量识别的路线。它适合对错误更敏感的场景:会议记录、访谈整理、媒体字幕和需要保留细节的多语言转写。
Audio8-ASR-0.6B:质量、速度与成本的平衡点 Audio8-ASR-0.6B 处在更实用的中间位置。它为 GPU 服务和本地工作站提供了更容易管理的资源预算,同时保留了面向真实录音的识别能力。对于需要批量处理、又不希望把全部预算投入到单次推理的团队,它是更自然的起点。
0.6B 产品线也覆盖面向 CPU 的量化与通用运行时形态。它的意义在于把模型带出 CUDA 依赖,让普通服务器和边缘主机也能参与转写。量化带来更低的存储与内存压力。
Audio8-ASR-0.1B:小模型的价值不是“缩水” 0.1B 系列面向的是另一类问题:当模型需要常驻在设备上,参数量、内存峰值和功耗会直接影响产品能否成立。Audio8-ASR-0.1B 保留了轻量路线的基础能力,并覆盖面向 ONNX Runtime 与移动硬件的运行时形态,方便在没有完整深度学习环境的设备上工作。
当 0.1B 被放进手机或边缘设备时,稳定的响应时间、可控的内存和低功耗比峰值性能更重要。它适合语音输入、现场记录、离线字幕和对隐私敏感的应用。
让语音识别留在设备上 移动端不是一台缩小的服务器。应用需要在前台和后台之间切换,电量与温度会改变可用算力,用户也会把隐私视为本地处理的重要理由。对 0.1B 产品线来说,端侧运行的意义正是把这些现实约束纳入模型设计,同一份模型需要针对不同硬件给出具体的落地方式。
面向 Apple 硬件的低功耗路径 这条路径以 Audio8-ASR-0.1B-iOS-ANE 为代表:模型以 Core ML 与 ONNX Runtime 的组合形式打包,直接运行在 iPhone 与 iPad 的 Apple Neural Engine(ANE)上,并配套 Swift 接入接口。ANE 是 Apple 芯片上的专用低功耗计算单元,把识别计算从 CPU 与 GPU 上移走后,转写能够在更稳定的功耗曲线下持续运行,适合语音输入、现场记录、离线字幕和对隐私敏感的应用。
通用运行时与移动体验 同一条 0.1B 产品线也提供跨设备的通用形态 Audio8-ASR-0.1B-onnx-runtime :基于 ONNX Runtime,运行时不再依赖 CUDA、PyTorch 或 Transformers,可在普通 x86/ARM CPU 边缘设备上运行,并提供 INT8、INT4 量化版本以进一步压缩存储与内存占用。
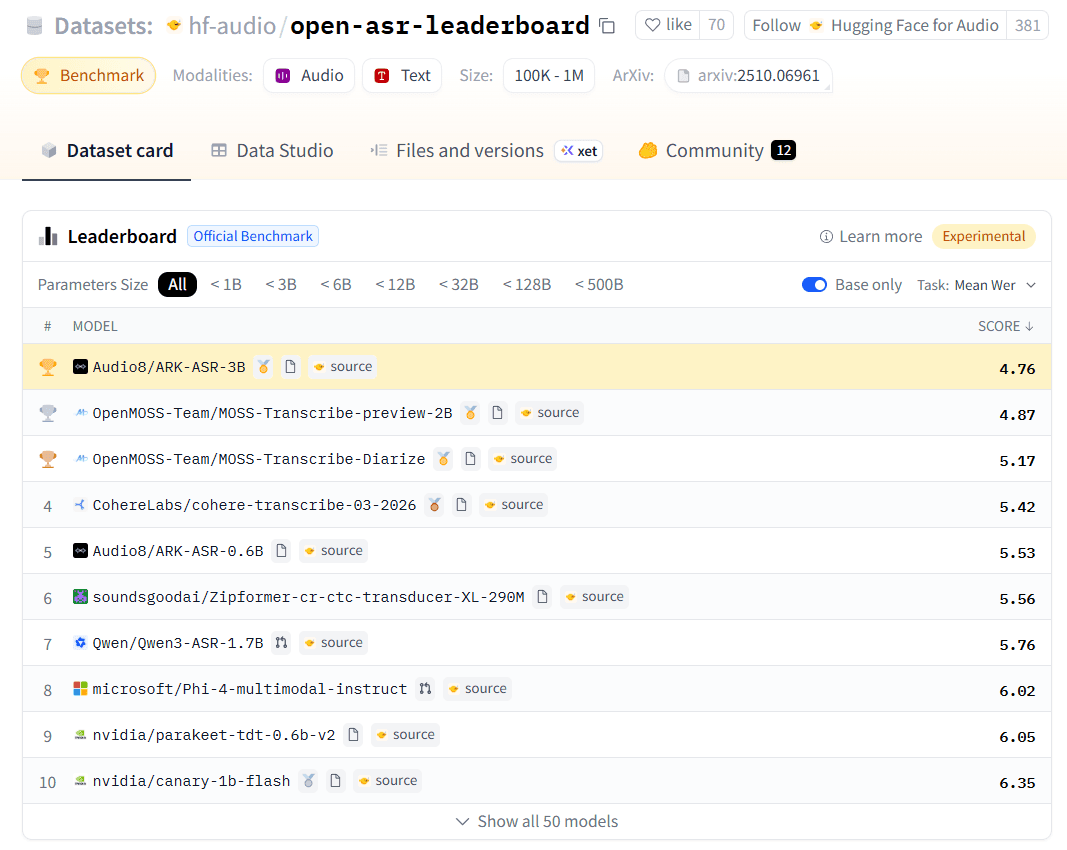
持续霸榜的识别性能 Audio8-ASR 在语音识别评测中持续霸榜数个月,中文 CER、英文 WER 与多语言转写均保持领先。从云端 3B 到端侧 0.1B,每一档模型都在目标设备上交付稳定、可靠的识别表现,复杂噪声、远场、口音和多人对话场景也不例外。
图 1:Audio8-ASR 持续霸榜数个月(数据截至 2026 年 9 月 4 日)。 评测维度 领先表现 识别质量 中文 CER、英文 WER 与多语言转写均保持领先 复杂场景 噪声、远场、口音、多人对话与长音频下保持稳定 运行效率 实时率、首字延迟与并发吞吐表现优异 设备成本 更低的显存与内存占用,功耗可控
从 3B 的高精度识别到 0.1B 的端侧运行,Audio8-ASR 把“听懂声音”落实到每一个规模,识别质量与部署成本同时成立。
从云端到本地:选择适合自己的模型 如果首要目标是复杂场景下的准确率,从 Audio8-ASR-3B 开始;如果需要通用 GPU 服务和更平衡的成本,选择 Audio8-ASR-0.6B ;如果部署条件以 CPU、边缘设备或手机为主,则应优先评估 0.1B 系列及其对应格式。
最稳妥的路径不是先问“哪个模型最大”,而是先确定音频从哪里来、必须多快返回、能消耗多少内存,以及哪些内容不能离开设备。模型家族的意义,就是让这些约束能够对应到一个明确的选择。
边界与负责任使用 自动转写是通用语音技术,结果仍可能受噪声、口音、重叠语音、专有名词和音频质量影响,并可能出现误识别或与事实不符的内容,不应作为未经复核的事实记录。医疗、法律、金融等高风险场景必须经人工审核,部署方应对最终输出负责。
处理个人声音、谈话内容或敏感信息时应依法取得授权并遵守《个人信息保护法》、GDPR 等法规,音频与文本需妥善加密、限权与限期存储。Audio8 不对模型准确性、可用性及特定用途适用性作任何保证,是否满足业务与合规要求由部署方自行判断。
Audio8-ASR / Model Family
从 3B 的高精度识别,到 0.1B 在手机上的低功耗运行,Audio8-ASR 把“听懂声音”拆成了面向不同现实约束的多条路线。