语音生成常常被简化成质量与可及性之间的取舍。大模型能够牢牢保留说话人的身份,读准棘手的文本,并在不同语言之间自然切换;小模型更容易运行,却往往要牺牲的正是这些能力。真正值得追问的工程问题,不是模型能不能做小,而是在缩小的过程中,一套完整的声音生成链路究竟还能保留下来多少。
Audio8-TTS 系列正是为了解开这组矛盾而设计。所有模型共享同一套生成框架,却分别落在质量—效率曲线的不同位置。Audio8-TTS-0.6B 是以质量为先的版本:它面向多语言、零样本 TTS,即使文本改变、甚至语言本身改变,也尽力让参考说话人的声音保持清晰可辨。Audio8-TTS-0.1B 则把同一思路压缩到 170M 参数,并配套 CPU 原生的 ONNX INT8 运行时。它的定位很具体:The smallest zero-shot TTS worth running.
| Audio8-TTS-0.6B | Audio8-TTS-0.1B |
|---|
| 主模型 | 601,159,424 个参数 | 170M 个参数 |
| 音频输出 | 44.1 kHz 神经音频编解码器 | 44.1 kHz 神经音频编解码器 |
| 语言重点 | 推荐 11 种语言 | 中文、英文优先;其他语言为实验性支持 |
| 主干架构 | Transformer DualAR | Falcon-H1 混合式 DualAR |
| 主要部署方式 | GPU 与 SGLang Omni | CPU 原生 ONNX Runtime INT8 |
0.6B 版本承载这次发布的质量主线;170M 版本则提出了一个更尖锐的问题:当生成模型必须挤进更紧的内存和算力预算时,零样本声音条件还能不能真正有用?两个预览版本放在一起,展示的是同一设计在两个规模上的实现,证明小模型是对同一蓝图的忠实实现,而不是一个固定音色的演示品。
同一声音的两个时钟
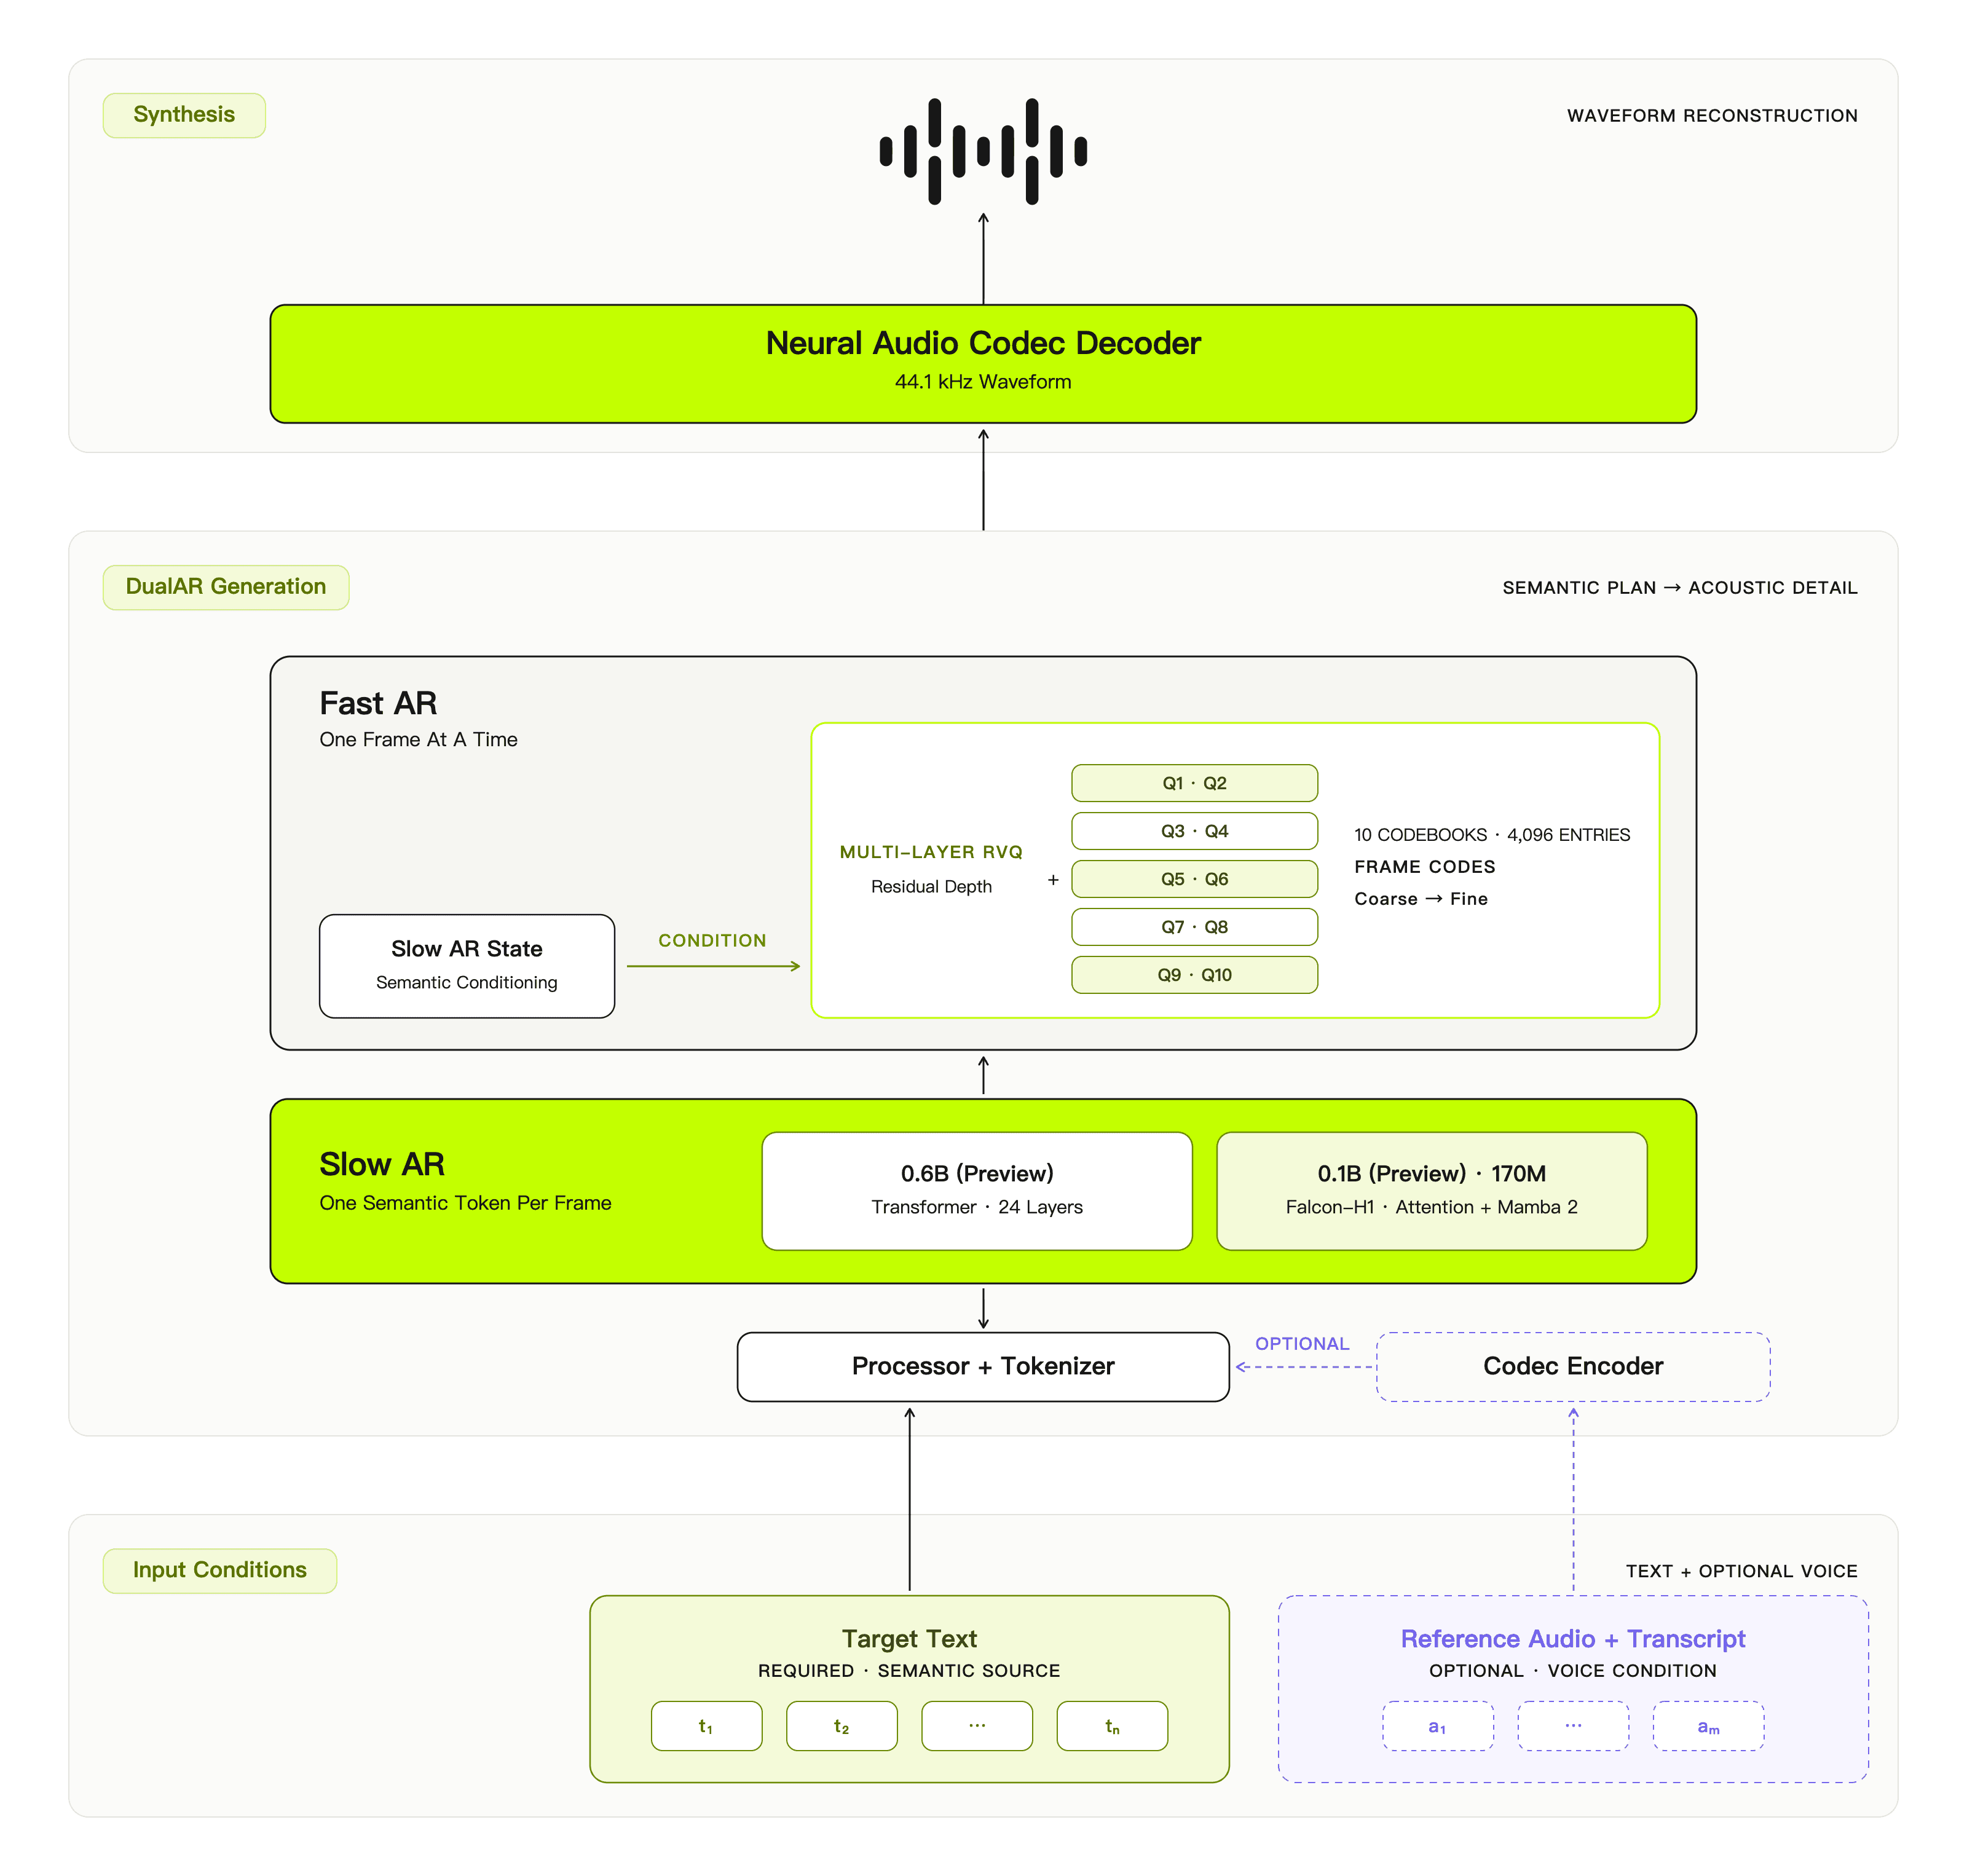
一句话的生成同时运行在两个时钟上。慢时钟跟随文本:决定一帧在哪里结束、下一帧从哪里开始,并让句子沿着完整的语义弧线保持连贯。快时钟填入每一帧的音色、咬字和频谱细节——正是这些细节,让声音明确属于某个说话人。让同一个序列模型以两种速率同时工作当然可行,但序列会被无谓拉长,结构与保真也会被迫争夺同一套表示。
Audio8-TTS 用受 Fish Audio S2 Pro 启发的 DualAR 架构解耦这两项工作。Slow AR 每个 codec 帧推进一个语义 token;Fast AR 读取 Slow AR 的隐藏状态,以及当前帧中已经生成的码本,然后渲染这一帧的声学代码。随模型提供的神经音频编解码器会编码可选的参考录音,并在链路末端将生成的代码解码为 44.1 kHz 波形。
多层 RVQ:一帧不止一个 Token
编解码器通过 10 个残差码本生成每一帧,每个码本都是一张包含 4,096 个条目的表。前几个码本先搭起这一帧的粗略骨架,后续码本再逐层补上残差,让发音、音色和更细的声学层次变得清晰。Fast AR 沿深度方向预测这组码本,因此模型可以把容量投向细节,而不必让语义流独自承担整条波形。
这也解释了两个自回归分支为什么能自然地拼在一起。Slow AR 以每秒约 21.5 帧的速度推进,展开一条可供长程上下文依赖的稳定序列;Fast AR 则在这个背景上完成更短的帧内解码。整条链路仍然端到端自回归,但 token 预算终于顺着语音的结构分配,而不是把每一层细节都压扁到一条序列中。
Audio8-TTS-0.6B
主模型包含 601,159,424 个参数,不计神经音频编解码器。两个分支的宽度都为 896,但深度刻意做了不对称设计:24 层 Slow AR 有足够空间承载跨时间的语音内容,4 层 Fast AR 则专注于每一帧中的十个码本。
| 组件 | 配置 |
|---|
| Slow AR | 24 层 Transformer,宽度 896,14 个注意力头,2 个 KV 头 |
| Fast AR | 4 层 Transformer,宽度 896,14 个注意力头,2 个 KV 头 |
| 声学表示 | 10 个码本,每个码本 4,096 个条目 |
| 神经音频编解码器 | 44.1 kHz,每个模型帧包含 2,048 个采样点 |
| 帧率 | 约 21.5 个模型帧/秒 |
| 上下文 | 最多 2,048 个打包后的文本/音频位置 |
在 44.1 kHz 下,2,048 个采样点约对应 46.4 ms。换算到每秒音频,Slow AR 大约做 21.5 次语义决策,Fast AR 再把十层残差信息填入每一次决策。静态 KV Cache 让早先的位置始终可用,模型不必在每个音频帧重新计算整个前缀。
编解码器随模型一同发布,而且承担两项工作:同一个组件既编码参考音色,又解码生成代码。整个推理路径因此只需要管理这一套组件,不必在链路中额外维护一份独立的音频 checkpoint。
170M 分支
Audio8-TTS-0.1B 保留 DualAR 的契约,并替换 Slow AR 的主干。它不再使用纯 Transformer,而是采用 Falcon-H1,将注意力与 Mamba 2 状态空间层结合起来。正是这一处架构调整,让主模型能够缩小到 170M 参数,同时保留语义到声学的交接方式,并继续输出同样的十个码本。
| 组件 | 配置 |
|---|
| 主模型 | 170M 参数,不计音频解码器 |
| Slow AR | 24 层,宽度 512,8 个注意力头,2 个 KV 头,Mamba d_state=64 |
| Fast AR | 4 层,宽度 512 |
| 声学表示 | 10 个码本,每个码本 4,096 个条目 |
| 神经音频编解码器 | 44.1 kHz,每个模型帧包含 2,048 个采样点 |
| 上下文 | 最多 2,048 个打包后的文本/音频位置 |
170M 只描述主生成模型。音频解码器是独立组件,约 120M 参数;要真正生成波形,它仍然会计入存储和内存预算。把两个数字分开,是为了让规模比较保持诚实,而不是假装编解码器不占资源。
Falcon-H1 也重塑了运行时状态。每个请求都为 Slow AR 携带自己的 FalconHybridMambaAttentionDynamicCache;语义采样、Fast AR 和音频解码仍与 0.6B 路径共享。在 GPU 服务中,Mamba 状态沿 eager 路径传递,而不是使用普通的 SGLang KV Page。
让训练目标映照架构
这种拆分不只存在于推理图中,也贯穿训练过程。音频先编码成 [10, T] 的码本索引数组,监督微调再在 teacher forcing 下,同时优化 Slow AR 的语义/EOS 目标和 Fast AR 的码本目标。需要只改动生成链路的一侧时,另一侧可以冻结。
数据接口保持得很小。目标音频是必需项;reference_audio 和 reference_text 可以省略,但只要使用,就必须成对提供。推理时,文本与参考音频共同占用一个打包的 2,048 位置上下文。代码仓库建议单次输入控制在约 150 个字符,并在完整语义边界处分割更长的内容。
零样本音色克隆:无需针对说话人微调
只有当模型能够分辨“谁在说话”和“说了什么”,音色克隆才真正有用。Audio8-TTS 不需要为每位新说话人单独微调,而是把一段较短的录音及其准确文本编码起来,再将这对输入作为新文本的条件。
inputs = processor(
    text=["Welcome to Audio8-TTS."],
    reference_audio=["reference.wav"],
    reference_text=["The exact transcript of the reference recording."],
    return_tensors="pt",
)

with torch.inference_mode():
    output = model.generate(
        **inputs,
        max_new_tokens=1024,
        temperature=0.8,
        top_p=0.95,
        top_k=50,
        do_sample=True,
        return_dict_in_generate=True,
    )
    waveforms, lengths = model.decode_audio(output.codes)
参考文本是条件的一部分,而不是事后附在录音旁边的备注。它把说出的内容与参考波形对齐,为模型留下更干净的说话人身份信号。录音干净、文本准确时,通常能获得最稳定的结果;噪声、过长的片段和错误转写,都会降低稳定性与音色相似度。
参考条件并非必需。如果同时省略两个参考字段,同一 checkpoint 就会变成普通的文本转语音模型。
语言在变,声音不变
Audio8-TTS-0.6B 覆盖中文、荷兰语、英语、法语、德语、意大利语、日语、韩语、波兰语、粤语和西班牙语,并在持续扩展更多语言。更难的考验是跨语言合成:中文参考录音可以引导英文语句,英文参考录音也可以引导中文。文本的语言发生变化,声音锚点却始终不动。
0.1B 的边界更为克制。中文和英文是主要语言;德语、西班牙语、法语、意大利语、日语和韩语属于实验性支持。
紧凑规模下的 SOTA-class 表现
在下面的对比中,Audio8-TTS-0.6B 是主模型规模最小的一项。在 Seed-TTS 上,它取得表中最低的英文 WER,中文 CER 也保持竞争力;在 CV3 上,它在公开的多语言评测中仍处于第一梯队。我们用 SOTA-class 描述这一位置,但不宣称它在每个指标或每种语言上都普遍领先。
Seed-TTS
WER/CER 越低越好,SIM 越高越好。表中 SIM 以百分比表示。
| 模型 | 参数量 | EN WER / SIM | ZH CER / SIM | Hard ZH CER / SIM |
|---|
| Audio8-TTS-0.6B | 0.6B | 1.506 / 63.2 | 0.950 / 73.1 | 11.510 / 68.7 |
| Fish S2 Pro | 4.6B | 1.607 / 64.6 | 1.038 / 73.8 | 10.149 / 70.1 |
| Higgs Audio v2 | 4.7B | 1.524 / 66.4 | 0.806 / 72.1 | 10.622 / 69.3 |
| CosyVoice3-1.5B | 1.5B | 2.22 / 72.0 | 1.12 / 78.1 | 5.83 / 75.8 |
| MOSS-TTS | 8.5B | 1.85 / 73.4 | 1.20 / 78.8 | - |
| VoxCPM2 | 2.3B | 1.84 / 75.3 | 0.97 / 79.5 | 8.13 / 75.3 |
CV3 多语言错误率
以下指标越低越好。
| 模型 | 参数量 | ZH | EN | Hard-ZH | Hard-EN | JA | KO | DE | ES | FR | IT |
|---|
| Audio8-TTS-0.6B | 0.6B | 3.205 | 3.128 | 10.535 | 5.997 | 7.205 | 4.223 | 3.447 | 3.641 | 8.790 | 4.790 |
| Fish S2 Pro | 4.6B | 3.600 | 3.493 | 10.588 | 7.349 | 5.139 | 4.111 | 3.605 | 2.972 | 8.600 | 4.229 |
| Higgs Audio v2 | 4.7B | 3.378 | 3.404 | 10.424 | 5.754 | 4.742 | 4.260 | 3.300 | 2.929 | 9.425 | 3.555 |
| CosyVoice3-1.5B | 1.5B | 3.91 | 4.99 | 9.77 | 10.55 | 7.57 | 5.69 | 6.43 | 4.47 | 11.8 | 10.5 |
| VoxCPM2 | 2.3B | 3.65 | 5.00 | 8.55 | 8.48 | 5.96 | 5.69 | 4.77 | 3.80 | 9.85 | 4.25 |
170M 模型并不是 0.6B 的同质量替代品。它在 Seed-TTS 上的公开结果为:英文 1.662 WER / 56.7 SIM,中文 1.13 CER / 68.2 SIM;在 CV3 上,中文为 3.619,英文为 3.307,部分实验性语言的差距更大。它的价值在于另一件事:在明显更小的部署预算下,仍然让零样本条件保持可用。
所有跨项目数据均来自公开模型卡和技术报告。由于归一化方式、评测器和测试集并不一致,这些数据应被视为参考比较,而不是严格控制变量后的统一排名。
从 Checkpoint 到可运行的服务栈
只有运行时能够承载参数量,参数规模才真正有意义。因此 Audio8-TTS 提供了两条侧重点不同的部署路径:0.6B 追求 GPU 吞吐,170M 则配套自包含的 CPU 运行时。
0.6B 的 GPU 服务
Audio8 仓库提供 SGLang Omni 适配器,支持分页注意力、动态批处理、参考音频编码、波形解码,以及兼容 OpenAI 格式的 /v1/audio/speech 接口。
该适配器基于 SGLang Omni 0.1.0(commit 68a572348837f7b004857b4b07993c20ade4c017)、SGLang 0.5.8、PyTorch 2.9.1+cu128、Transformers 4.57.1 和 BF16 权重完成验证。在单张 NVIDIA H20 上的 warm 单流测试中,生成 128 帧的 p50 延迟为 0.691 s,RTF 为 0.116。测试不包含冷启动和编译时间;这些数字只描述测试配置,不是普适的延迟保证。
ONNX INT8:为端侧系统设计的 170M 路径
独立发布的 Audio8-TTS-0.1B ONNX INT8 不只是量化 checkpoint。它围绕 ONNX Runtime 打包了自回归循环、音频编解码、音色注册和服务接口,模型下载之后,运行时不需要 CUDA、PyTorch 或 Transformers。
| 组件 | 运行时表示 |
|---|
| Slow AR | INT8 逐 token 图,显式传递循环状态 |
| Fast AR | INT8 逐 token 图 |
| 音频编码器与解码器 | FP16 |
| 输出波形 | FP32、44.1 kHz、单声道 |
Slow AR 图会在相邻 token 之间显式传递注意力和 Mamba 状态。valid-prefix attention 将计算限制在有效前缀内。Fast AR 也沿用相同的逐 token 边界,生成每帧内部的码本。把循环状态显式暴露出来,比把整个循环封装成一个庞大的静态图更容易在 CPU 上调度、检查和限定内存。
在报告的测试中,常规推理在加载后约占用 0.4 GiB。测试平台:Linux x86_64。 内存占用会随 ONNX Runtime 构建、分配器、线程数和硬件变化。在 8 线程主机上,Slow AR 每个 token 约 19 ms,Fast AR 每帧约 8 ms,一次性的 prefill 成本约为每个提示词 token 19 ms。这些数字适合作为参考点,正式部署仍应在目标 CPU 上重新测量。
把音色注册移出热路径
普通合成只需要 Slow AR、Fast AR 和音频解码器。注册新参考音色时才加载音频编码器,将录音和文本转换成可复用的音色代码;完成后即可卸载编码器,再恢复合成。音色注册因此成为一次性的生命周期操作,而不是每个请求都要支付的常驻成本。
独立的 onnx_runtime_0_1b_int8 实现包含命令行推理、本地 HTTP 服务、流式 PCM、音色注册和兼容 OpenAI 格式的接口。从模型文件到服务边界,部署链路都已经覆盖,而不只是一组导出的计算图。
零样本克隆最适合使用干净的参考录音和准确的文本,并且必须获得说话人授权。合成语音可能被用于冒充或传播误导性信息;在适当场景中披露生成音频,并在投入生产前评估准确性、安全性和法律合规性。
Audio8-TTS
从 SOTA-class 的 0.6B 主模型,到可在 CPU 上运行的 170M 部署路径:让高保真零样本语音合成在不同计算预算下真正落地。