Edge0:3G内存运行35B大模型
SSD 专家卸载 · Prerouter 路由预测
2026 年 09 月 10 日
稀疏混合专家模型(MoE)让大模型只调用一部分参数完成一次计算,却留下了一个端侧部署难题:没有参与当前计算的专家,依然要有地方存放。如果把全部权重都留在内存里,稀疏计算节省下来的算力,并不会自动变成更低的设备门槛。让大模型在本地运行,需要同时解决权重存储、数据搬运和计算调度。
Edge0 是面向这一问题的开源流式 MoE 推理框架。它把 SSD 专家卸载与 Prerouter 路由预测 组合成一条完整推理路径,并发布 35B 与 8B 两个模型档位。现阶段,Edge0 通过 MLX 运行在 Apple Silicon 设备上:专家权重按需从 SSD 读取,预测头随模型一起交付,让存储与计算在同一套框架内协同工作。
两个模型档位,同一套流式推理框架
Edge0 的两个档位分别基于 Qwen3.5-MoE 35B-A3B 与 Ling 3.0。每个档位都由 4-bit 权重和训练好的 Prerouter 预测头组成,作为完整管线配合使用。表中同时列出模型规模、每步激活规模和内存占用,是因为它们分别决定了模型的能力上限、单步计算量和设备门槛。
| 模型档位 | 基座架构 | 层数 / 专家 | 推理配置 | 权重磁盘占用 | 短上下文峰值活跃内存 |
|---|
| Edge0-35B-A3B | Qwen3.5-MoE 35B-A3B | 40 层 / 256 个路由专家 | 4-bit / K = 4 | 约 23 GB | 约 2.9 GiB |
| Edge0-8B-A1B | Ling 3.0 | 24 层 / 128 个路由专家 | 4-bit / K = 8 | 约 4.2 GB | 约 1.0 GiB |
从稀疏激活,到权重按需抵达
MoE 的路由器会为输入选择少量专家。但在 SSD 卸载场景下,选出专家只是第一步:若权重尚未就绪,计算就需要等待读取完成。逐层重复“计算、路由、加载、再计算”,会让磁盘访问进入生成每个 token 的关键路径。
Edge0 把这条路径拆成两个相互配合的部分。SSD 保存专家权重,流式专家池负责缓存与搬运;Prerouter 提前预测后续需要的专家,为读取争取时间。读取、缓存和计算因此可以连续衔接,磁盘访问对生成速度的影响也随之降低。
框架也区分处理提示词的 Prefill 和逐 token 生成的 Decode。前者可利用整层加载与批量计算,后者更依赖专家缓存、预取和调度。两种架构共用同一条流式推理路径,路由宽度则分别匹配各自的模型结构。
SSD 专家卸载:让活跃工作集留在内存
Edge0 不会把所有专家权重一次性放进内存,而是根据当前计算需要,从 SSD 取出对应部分,并把刚用过的内容暂存在内存里。接下来可能用到的专家会提前准备,减少等待。这样,SSD 负责容纳完整模型,内存只承担眼前的计算;设备的可用内存、缓存状态和 SSD 速度,都会影响实际生成速度。
Prerouter:把下一步的等待提前处理
Prerouter 使用训练过的轻量预测头,结合隐藏状态与路由特征,提前预测后续专家选择。其核心是跨层、跨 token 的双移位:第 N 层在当前 token 上生成预测,供后续 token 的下一层使用。预测结果在生成步骤边界提交,让专家加载能够与前向计算重叠。
项目方在相同模型、适配器和负载下,将 Prerouter 与原生路由交替运行;结果显示,解码速度最高提升 59%。实际收益会随专家工作集、缓存命中、路由宽度和存储条件变化。由于预测路由参与了实际执行,质量结果反映的也是完整量化与适配管线的表现。
SSD 专家卸载与 Prerouter 路由预测共同带来一个关键变化:模型的总参数规模,不再等同于每一步都必须常驻的内存规模。下面从速度、活跃内存和质量三个维度,看这套设计在实际运行中的表现。
实测表现:速度、内存与模型质量
运行性能测试使用 Mac mini M4 Pro,24 GB 统一内存;质量评测由项目方通过 OpenCompass,在相同设置与参数下比较 Edge0 完整 int4 管线和原始 fp16 基座。下图展示五项质量评测结果,表格汇总对应的运行表现。
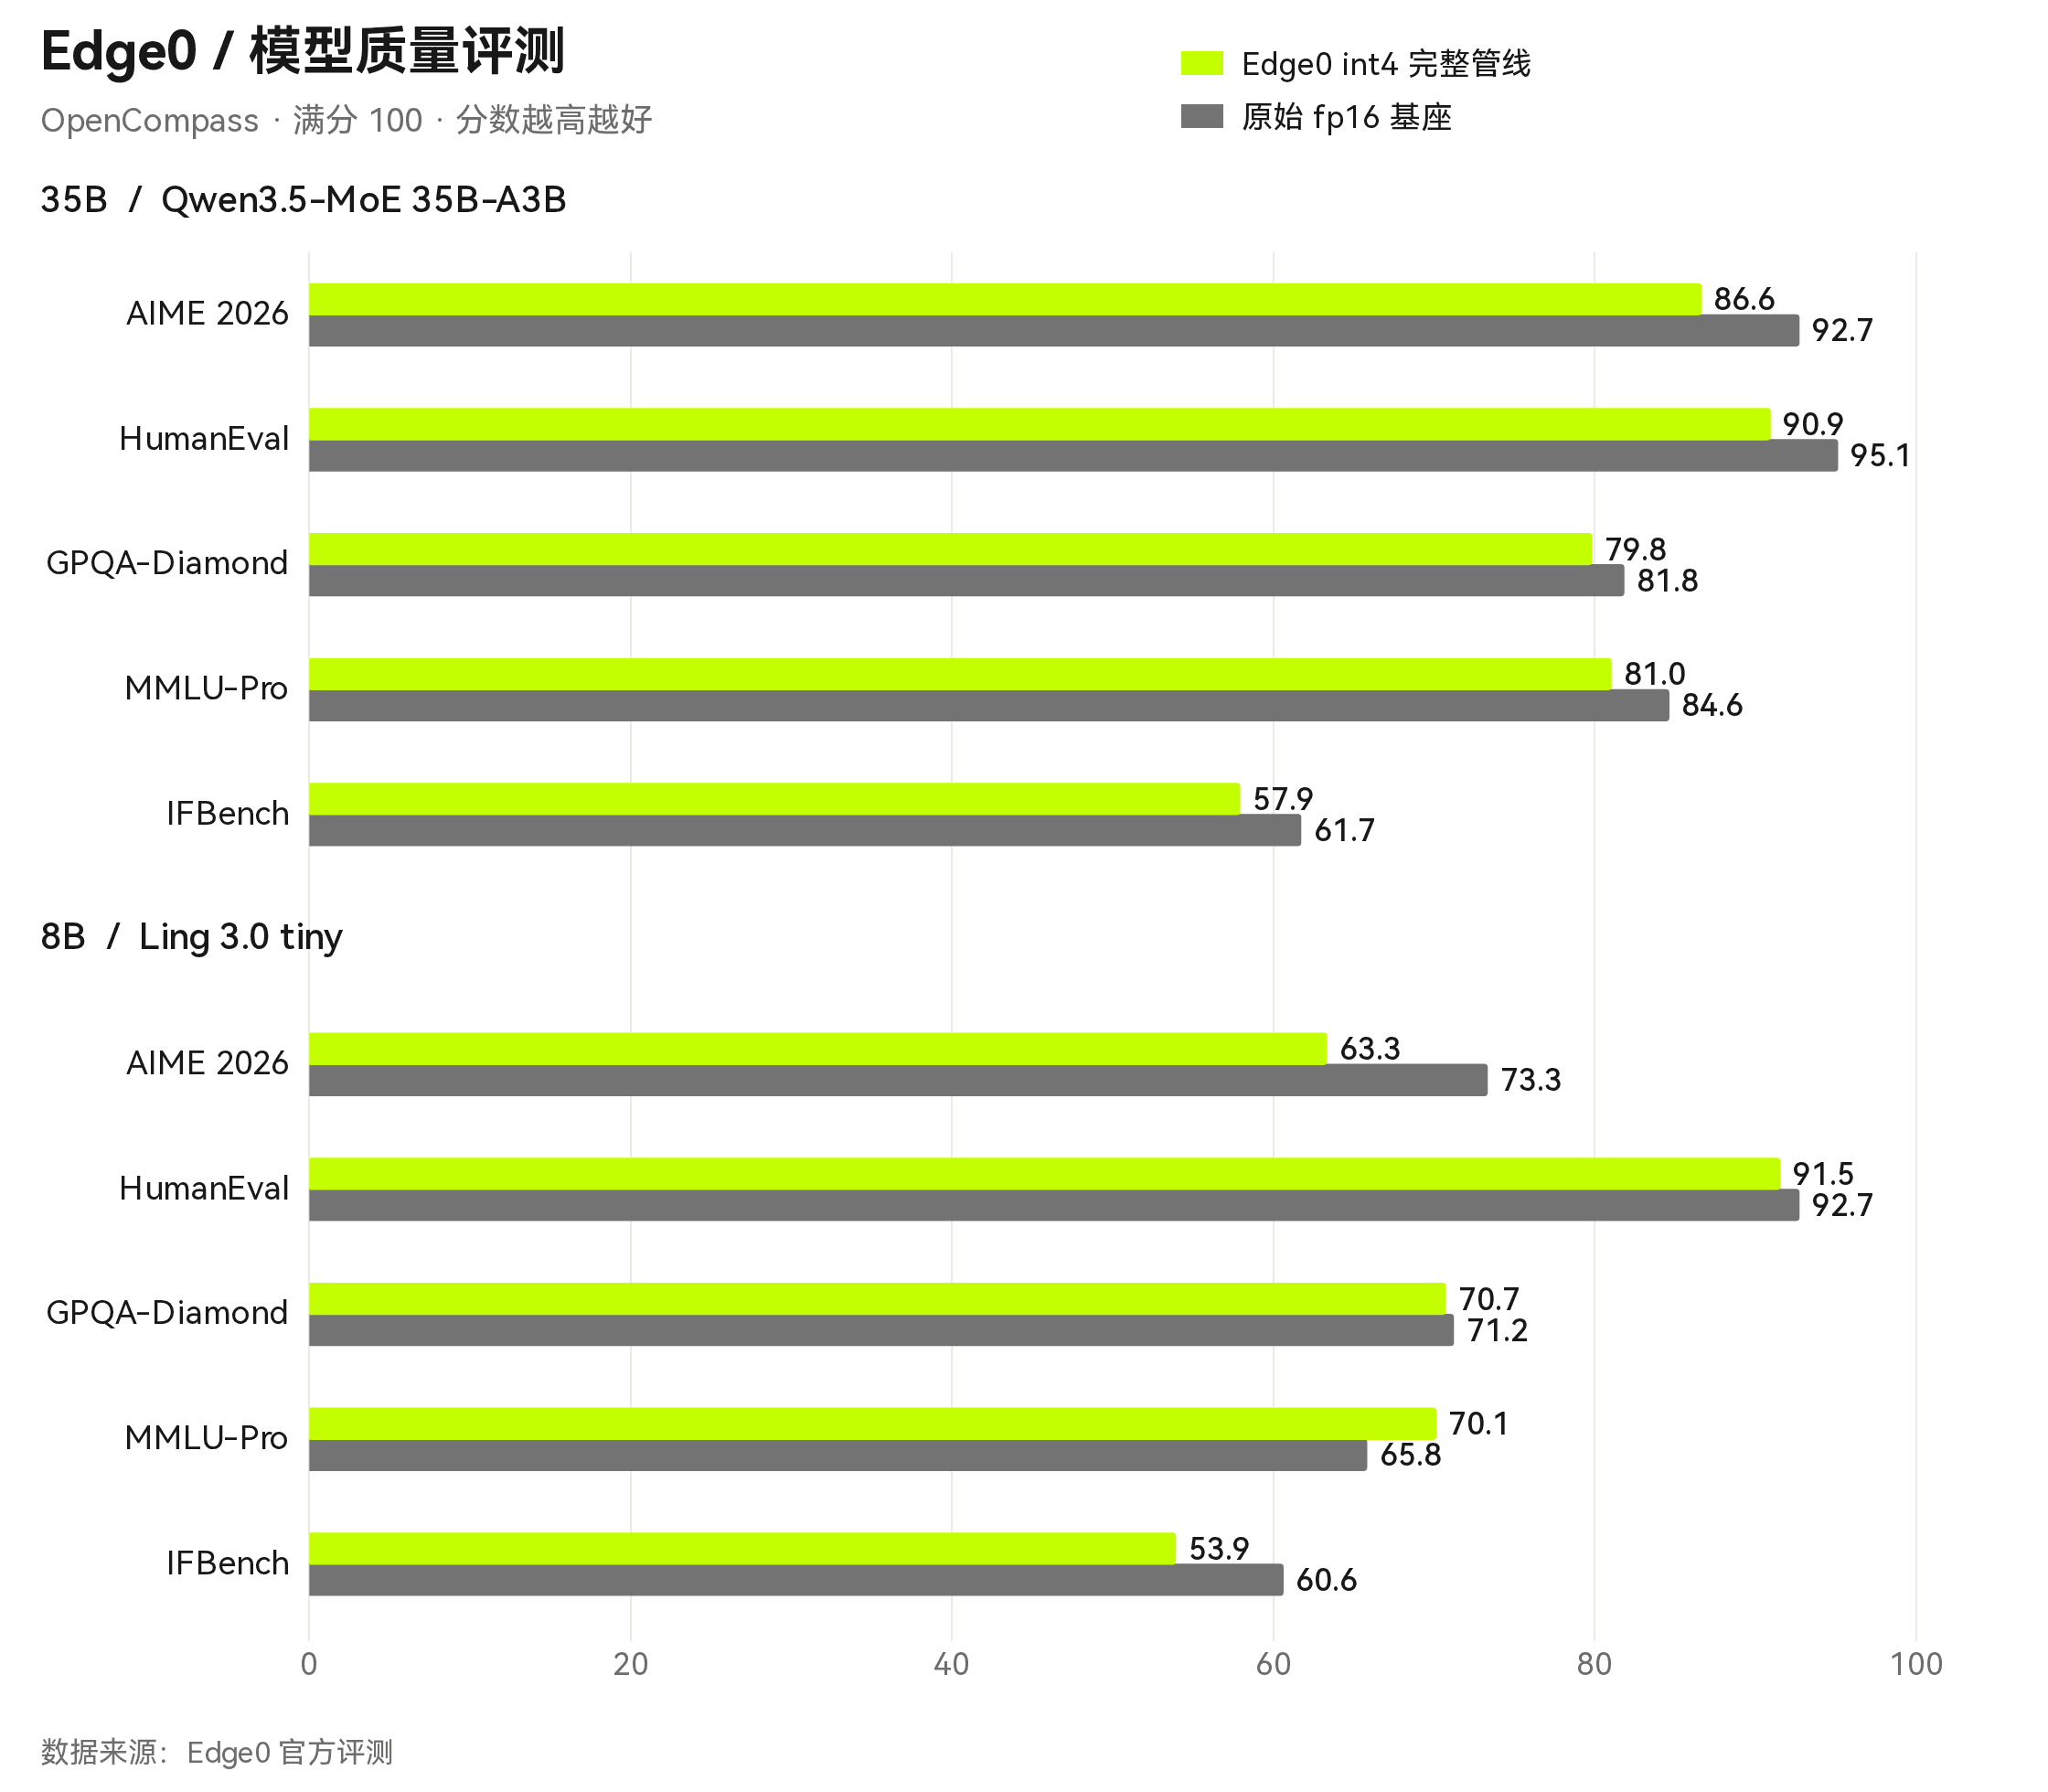 图 1:Edge0 int4 完整管线与对应 fp16 基座的质量对比,满分 100,分数越高越好。
| 性能指标 | edge0-35b | edge0-8b |
|---|
| 解码速度 | 14.9–17.7 tok/s | 23.9–25.3 tok/s |
| Prefill 吞吐,冷 / 热 | 113 / 140 tok/s | 500 / 1428 tok/s |
| 短上下文峰值活跃内存 | 2.9 GiB | 1.0 GiB |
| 测试设备 | Mac mini M4 Pro,24 GB | Mac mini M4 Pro,24 GB |
性能测试使用约 3.3k token 提示词、10 步采样预热和 200 token 计时解码,每个档位运行两轮。冷 Prefill 代表进程启动后的首次请求,热 Prefill 则受益于已经驻留的页缓存。表中内存按短上下文场景的 MLX 分配器峰值统计,反映的是推理工作集,不等同于进程总内存;在 3.3k token 上下文下,8B 档位的整体占用约为 3.3 GiB。
内存效率与推理速度兼得,模型能力保持稳定
在 AIME 2026、HumanEval、GPQA-Diamond、MMLU-Pro 和 IFBench 五项评测中,35B 管线平均分为 79.2,对应 fp16 基座为 83.2;8B 管线为 69.9,对应基座为 72.7。按公布单项分数计算,平均差距分别约为 3.9 分和 2.8 分。8B 的 MMLU-Pro 得分为 70.1,高于基座的 65.8,但不同任务的变化并不一致。
这些分数衡量的是量化、训练适配器与预测路由共同组成的完整管线。8B 档位更适合内存受限、强调交互速度的设备;35B 档位则为复杂任务保留更高的能力上限。实际应用中的表现仍会受到提示词、上下文长度和输出长度影响,尤其是在页缓存变冷或上下文变长时。
把端侧推理做成完整路径
Edge0 的实现把模型、路由、流式专家池和服务层与具体后端分开,现阶段通过 MLX 支持 Apple Silicon。存储、内存和计算由同一条推理路径统一调度,端侧运行因此不再只是把模型搬到设备上,而是对整套资源关系重新安排。
Edge0 以 Apache-2.0许可发布,模型与第三方组件的具体使用条件以对应发布页为准。
延伸阅读
Edge0 / Streaming MoE Inference
用 SSD 承载专家权重,用预测路由提前安排读取。Edge0 将本地推理建立在存储、内存与计算的协同设计之上。