写在前面
过去四年,大模型领域打得最凶的一场仗,不在排行榜上,而在内存里。
「内存墙」不是 AI 时代的词。1995 年,计算机体系结构学者 Wulf 和 McKee 写过一篇论文,题目叫《撞上内存墙》。他们当时担心的事情很朴素:处理器一年比一年快,内存却几乎跟不上。拖住一个系统的,往往不是它算得多慢,而是数据搬得多慢。
三十年过去,这堵墙换了个位置重新立起来——这一次,它立在 AI 面前。
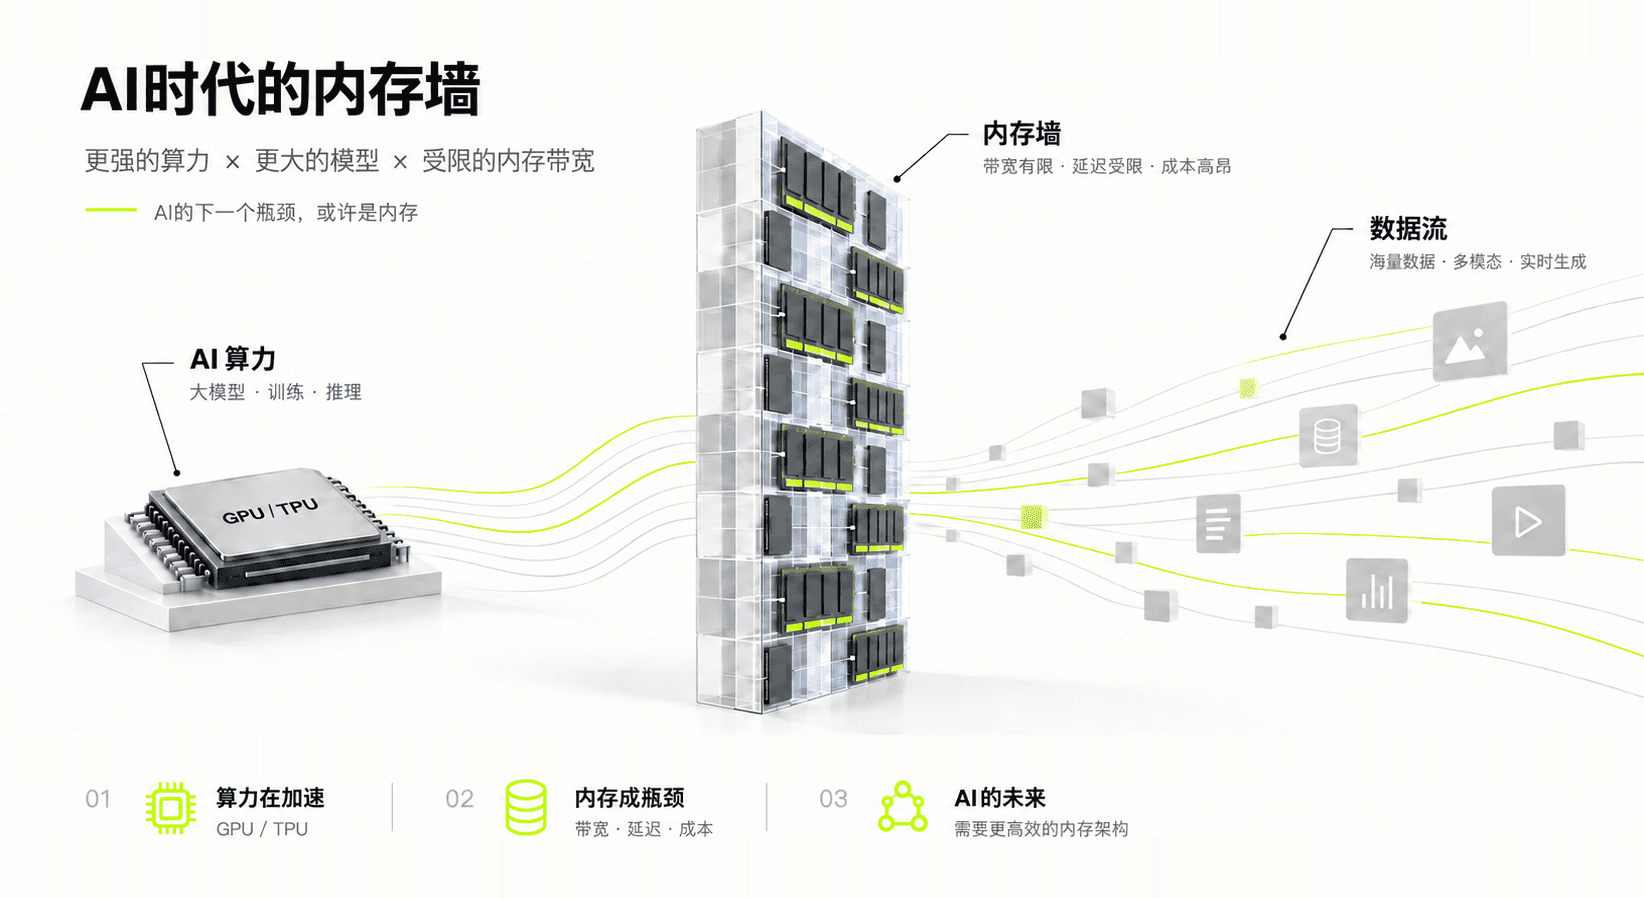
过去四年,行业最热闹的话题一直是算力:多少张卡、多少万亿次浮点运算、多少个亿美元。但真正决定一个模型跑不跑得起来、跑得多快、谁用得起的,常常是内存:几十 GB 的权重放在哪里,随对话增长的缓存放在哪里,每生成一个字要搬多少字节。这篇文章讲的就是这堵墙在 AI 时代的形状,以及我们已经走到了哪一步。
一、瓶颈不是算力,是内存
一个 350 亿参数的模型,做 4bit 量化之后,光权重就要 20 多 GB;再加上对话上下文和中间结果,一台普通电脑的内存装不下。这是最直觉的解释,也是最容易被当成全部的解释。
行业很早就给出了更准确的解释:瓶颈在内存。
为什么不是算力?因为在生成阶段,模型每吐出一个字,都要把「全部权重 + 全部上下文」完整搬过一遍内存总线,而这一趟搬运里能做的浮点运算少得可怜。也就是说,这一步的价格标签是字节数,不是运算次数。算力再富裕,也绕不过搬运。
浪费到了什么程度?一个 700 亿参数的模型(BF16)在 H100 上做单用户解码,算力单元有 99.8% 的时间在等权重从显存里过来,只跑出了芯片峰值的 0.2%。判断一个负载是被算力卡住还是被带宽卡住,看算术强度就够了:解码大约是每搬运 1 个字节做 1 次运算,而这张卡的平衡点在 295 左右。差两个数量级。加算力没有用,加带宽才有用。
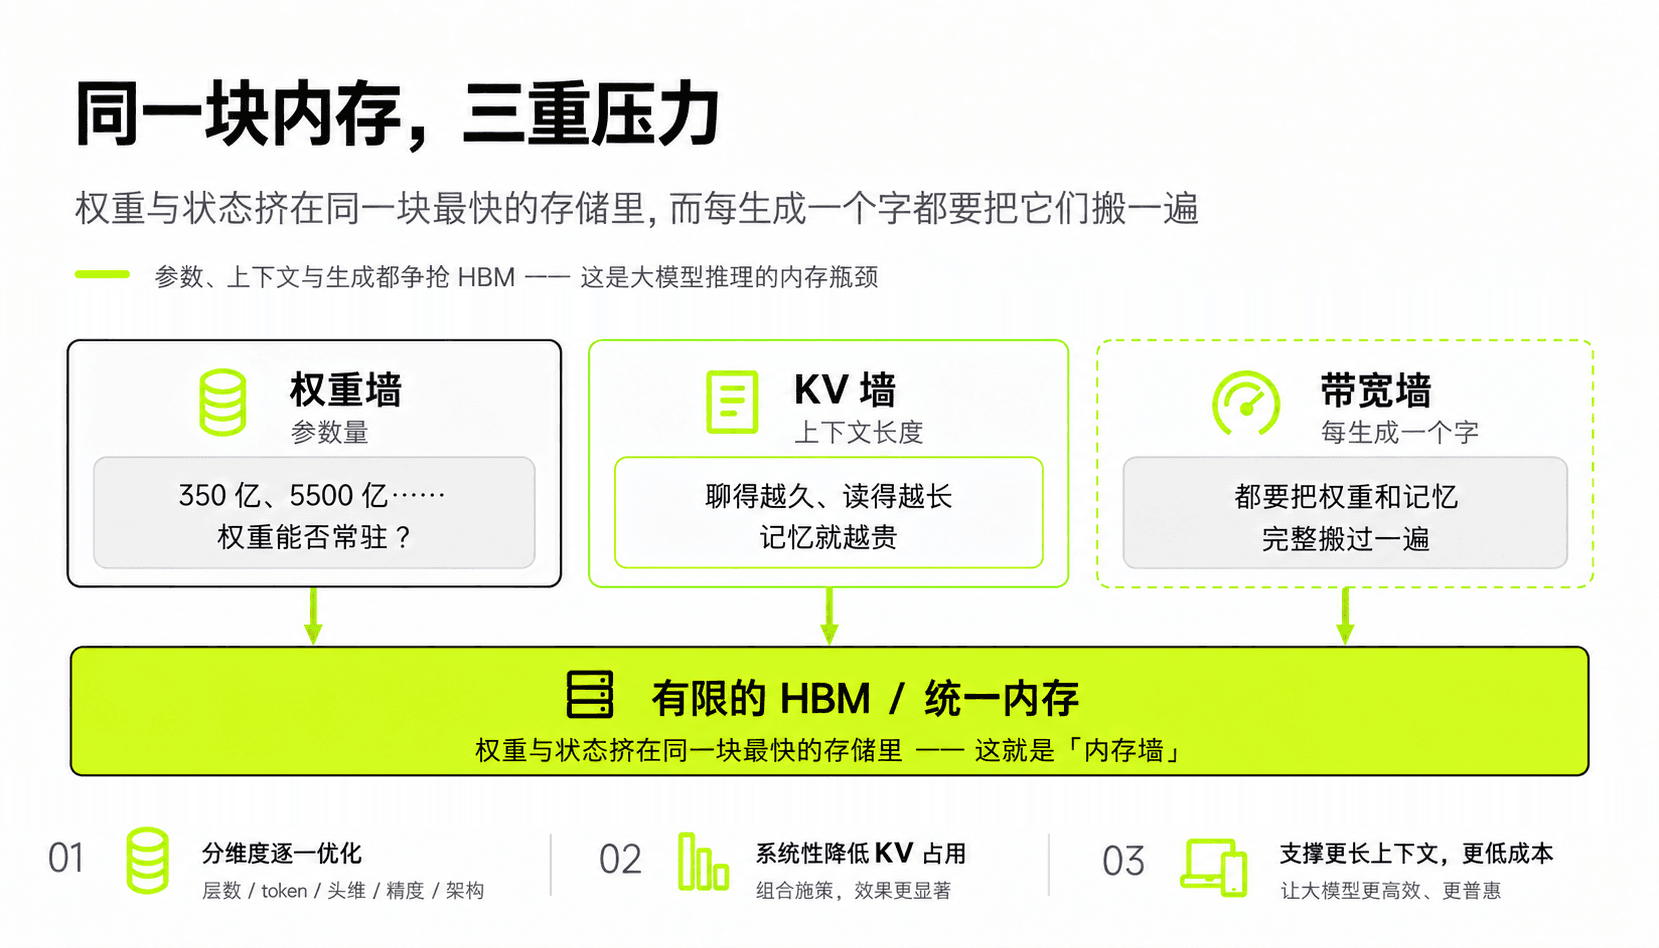
而「内存」这个词底下住着两个占用方,脾气完全不同。
权重是静态的巨物:几十 GB,训练完就不再变,可每生成一个字,它都要被完整读一遍。状态(也就是 KV 缓存)是动态的增长物:一开始很小,随着对话变长线性膨胀,每多一个 token 就要多存一份。
两者的出路不一样:一边的体积从一开始就定死了,一边会随着对话一直长。过去四年,行业绝大多数公开工作都花在了后一半上;而端侧真正的战场,在前一半。下面分开讲。
二、权重这一侧:先变小,再碰壁
权重只有一个算式:参数量 × 每个参数占几个 bit。权重这一侧所有的办法,都落在这两个变量上。
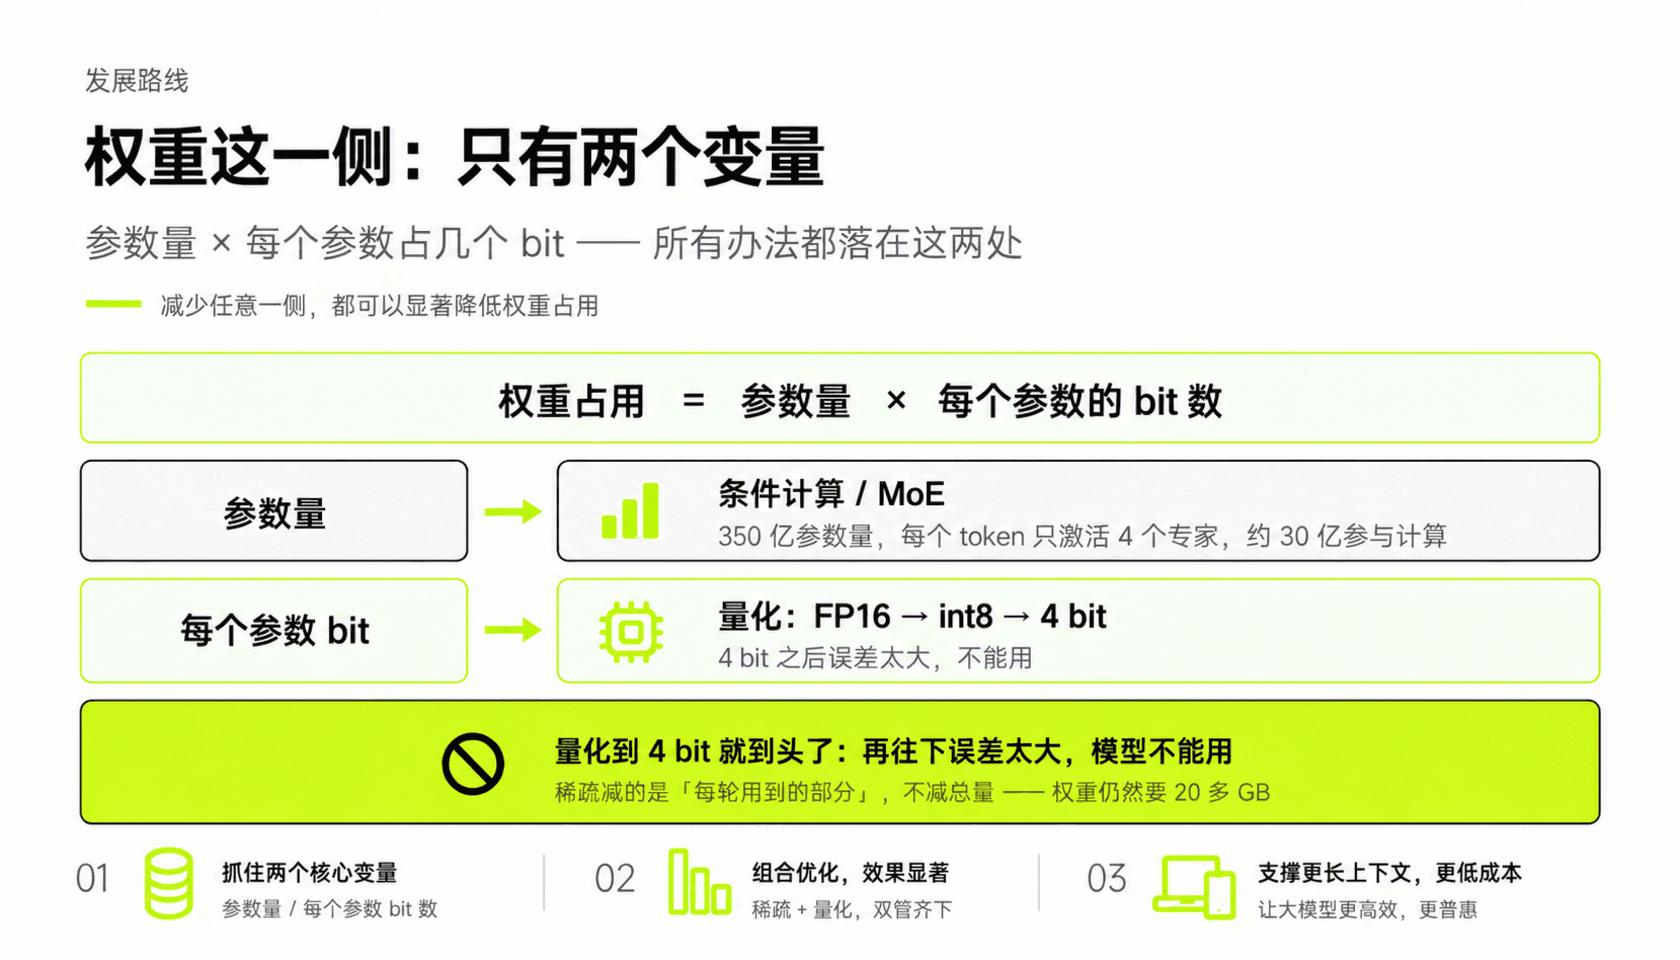
精度这条轴最直接。16 bit 压到 8 bit 几乎无损,压到 4 bit 是今天端侧的工程甜点:350 亿参数因此只要 20 多 GB。
再往下就没有路了:4 bit 之后,误差太大,不能用。2 bit、1 bit 到今天也没有能用的方案。掉的不止一两个点,是通用能力成片地坏掉。精度这条轴到 4 bit 就到头了。
就算压到 4 bit,350 亿参数的权重还是 20 多 GB,塞不进一台普通电脑的内存。
这里还有一件容易被忽略的事:这 350 亿参数并不是每次都全部上场。MoE 的结构决定了每个 token 只激活 4 个专家、大约 30 亿参数参与计算,其余的这一刻是闲着的。
但「闲着」不等于「不存在」。这 20 多 GB 总得有一个地方放着,而普通设备的内存只有那么大:机房里的解法是加内存、加卡,端侧没有这条路。这就是端侧那道墙本身。
三、状态这一侧:为什么聊得越久越贵
状态和权重正好相反。权重装载一次可以反复使用;KV 缓存则是生成一个 token 就追加一份,而且只要这轮对话还在继续,它就不能丢。下一次计算还要把历史重新读一遍——聊得越久、读得越长,这笔账就越贵。
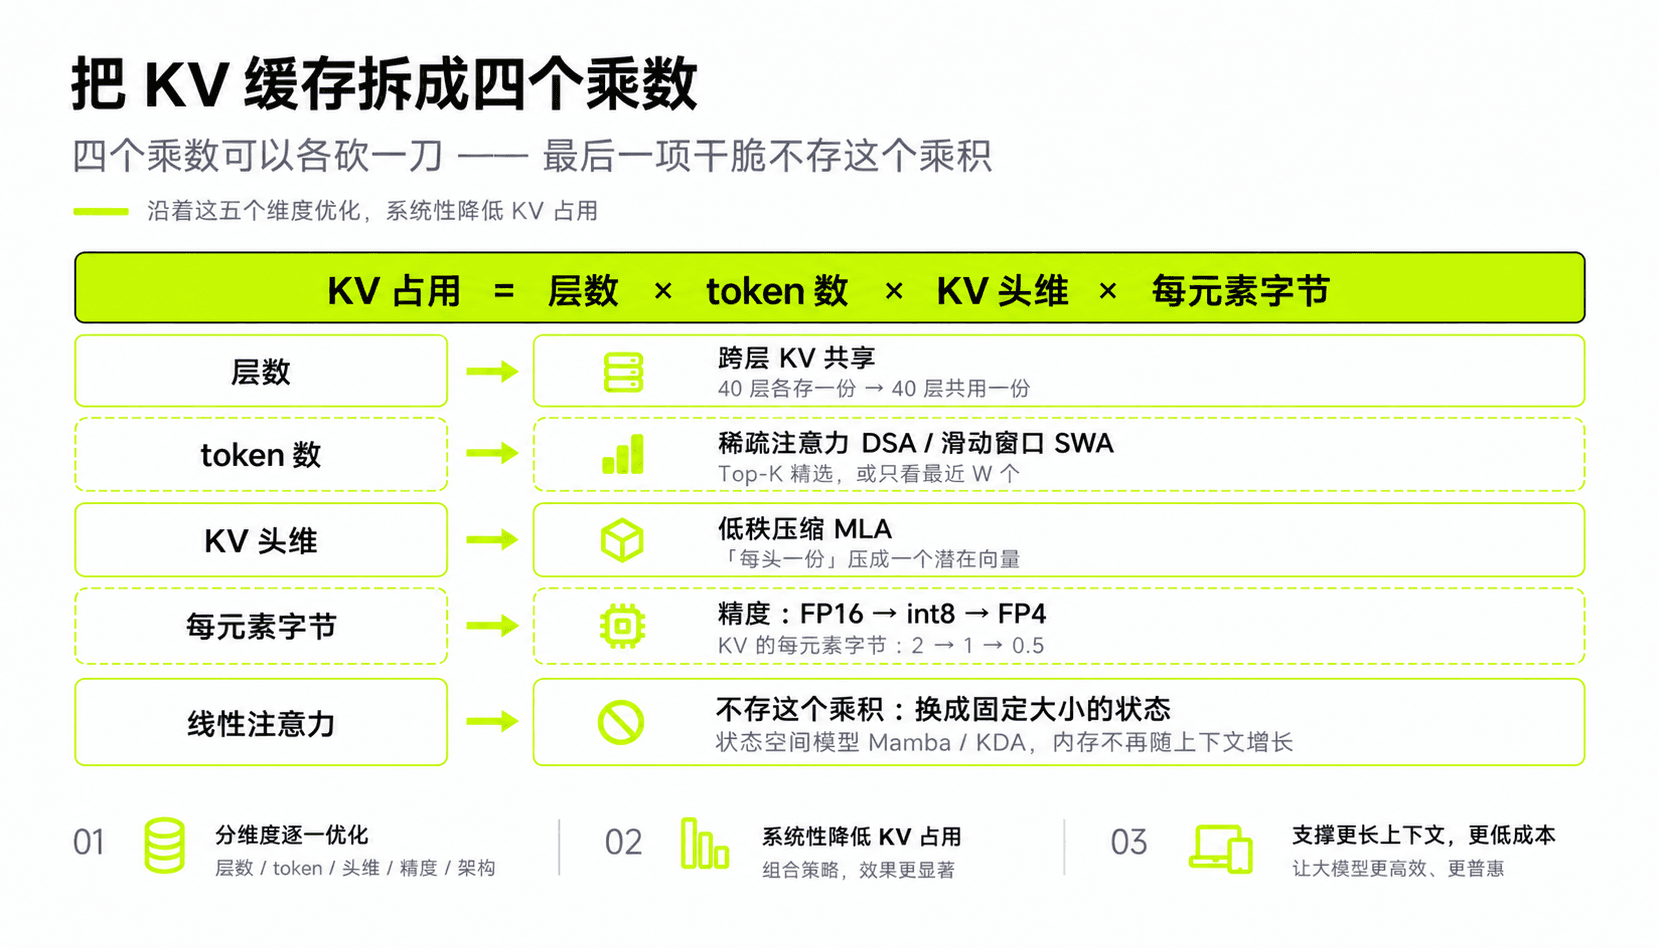
一块 KV 缓存占多少内存,写出来是一个乘法:层数 × token 数 × KV 头维 × 每元素字节。四个乘数,每个都能单独砍。
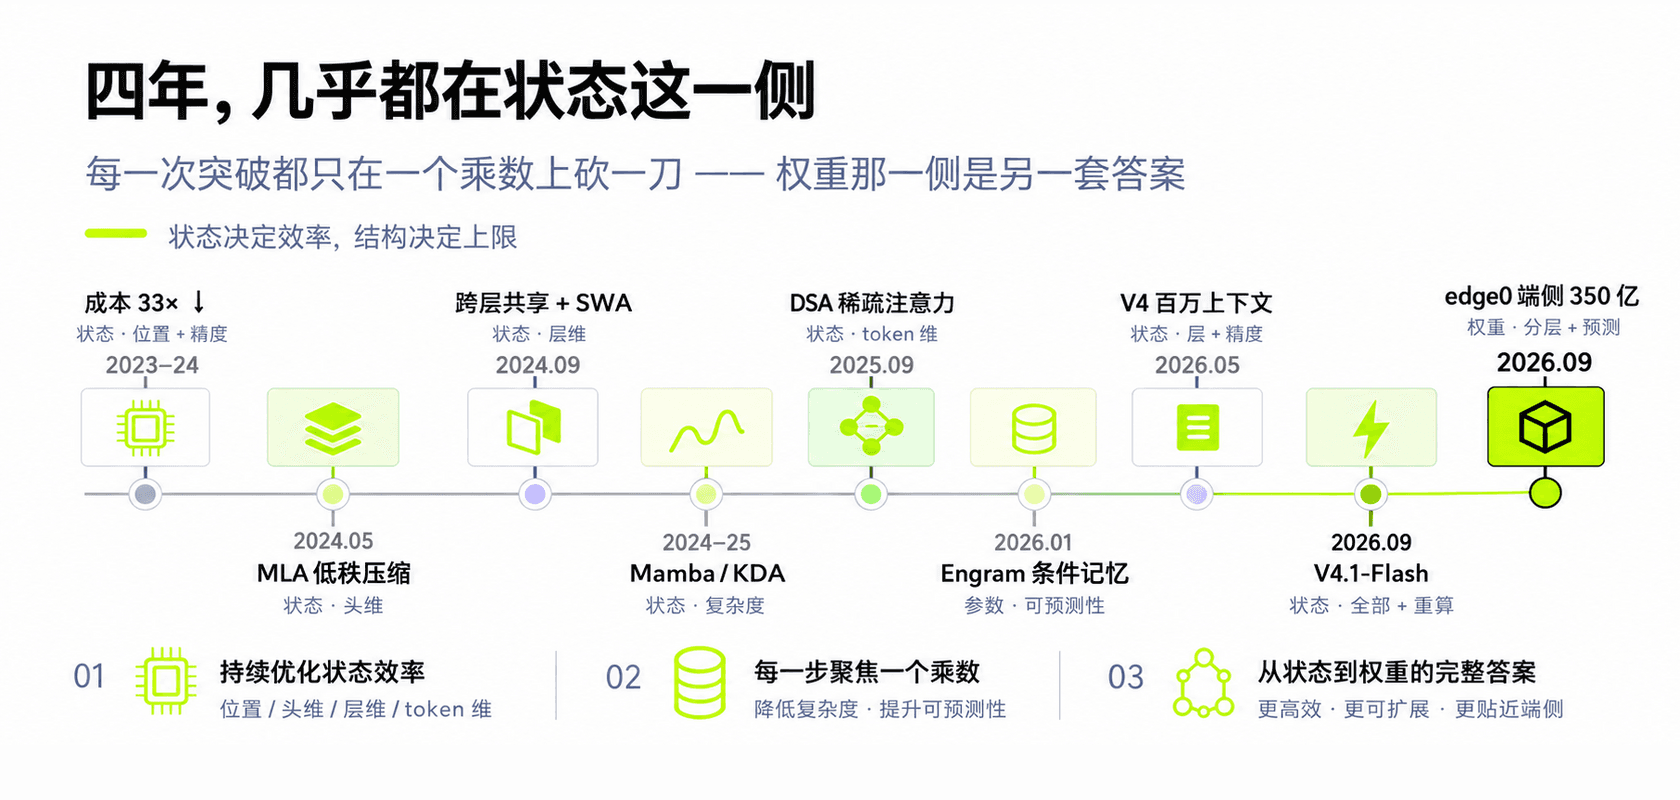
四条路线各有代表作,把它们按时间排开:
挑几条说。
MLA(2024 年 5 月)把过去「每个头存一份缓存」压成一个低秩向量。官方口径是相对标准的多头注意力减少 93.3% 的 KV 缓存,它后来成了整个 DeepSeek 系列的底座,后面所有的稀疏化都叠加在它之上。
DSA(2025 年 9 月)换个思路:不压缩缓存,而是决定该看哪些。一个轻量索引器先挑出最相关的约 2048 个位置,核心注意力的复杂度从 O(L²) 降到 O(Lk),官方随即把 API 价格下调一半以上。代价写在训练流程里:先用密集注意力预热,让索引器学会模仿原来的分布,再切到稀疏训练。
跨层共享是目前最直接的一招:40 层的缓存高度相似,为什么要存 40 份。到今年 9 月的 V4.1-Flash,它已经细化成给每层分配不同模式——少数层老老实实通读全部上下文并生成完整缓存,其余层直接复用别人算好的结果。
还有一条更彻底的路线:不要 KV 了。Mamba、DeltaNet、KDA 这些工作把随长度增长的状态换成一个固定大小的向量,内存不再随上下文增长。
这几条路线看起来互不相干。但如果换一个角度看,它们其实在回答同一个问题:这份缓存应该怎么被寻址。
全注意力是内容寻址:拿当前的问题去和历史逐条比对。最精确,代价也随长度一直涨。
线性注意力把历史压成固定容量的状态,相当于一份有损摘要:容量恒定,细节会丢。
稀疏注意力是两步寻址:先廉价地粗筛,再精确地细查。
Engram 回到最古老的方案——哈希寻址,O(1) 查表;MoE 则是按 token 决定用哪部分参数,相当于对参数做寻址。
摆进同一个框架,主线就清楚了:行业一直在换的是寻址方式,目标始终没变——用更少的字节,保住更多的精确回忆。也正因为这条底线在,混合架构才会成为共识:留下 5% 到 15% 昂贵但精确的层,就是在为「精确」单独付费。
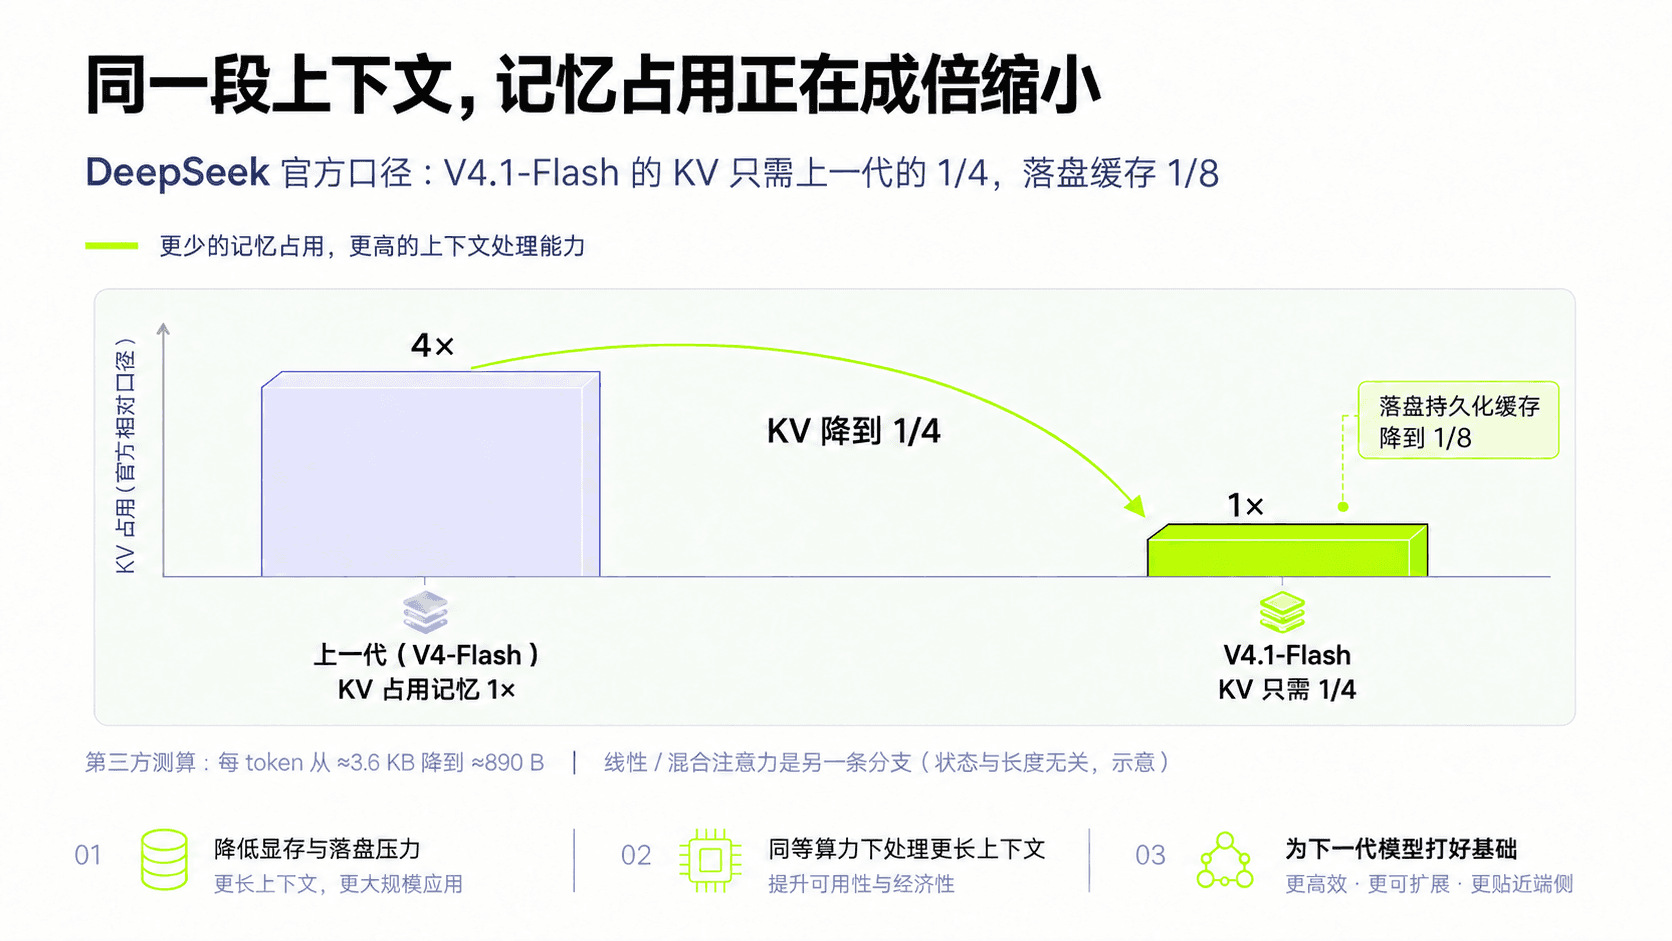
效果是能量出来的。按 DeepSeek 官方口径,V4 在 100 万 token 上下文下,只需要上一代 V3.2 的 27% 单 token 推理算力、10% 的 KV 缓存;到了 V4.1-Flash,KV 占用又降到上一代的 1/4,落盘的持久化缓存降到 1/8。
百万 token 的上下文,曾经意味着不可承受的成本。现在它开始变成一个工程问题。
回头把这四年最常被引用的一批工作放在一起看,会发现它们动刀的地方几乎都在状态这一侧:MLA、稀疏注意力、滑动窗口、线性注意力,指向的都是 KV。以至于「内存优化」经常被直接等同于「KV 优化」。但内存墙的另一半、那几十 GB 的权重,从来没有因为 KV 变小而变小。到了端侧,真正塞不下的是它。
四、两侧的会合点:摊到整条存储链上
如果压缩是「让东西变小」,那还有另一半故事:把东西搬到别的地方。这一步,权重和状态是同路人。
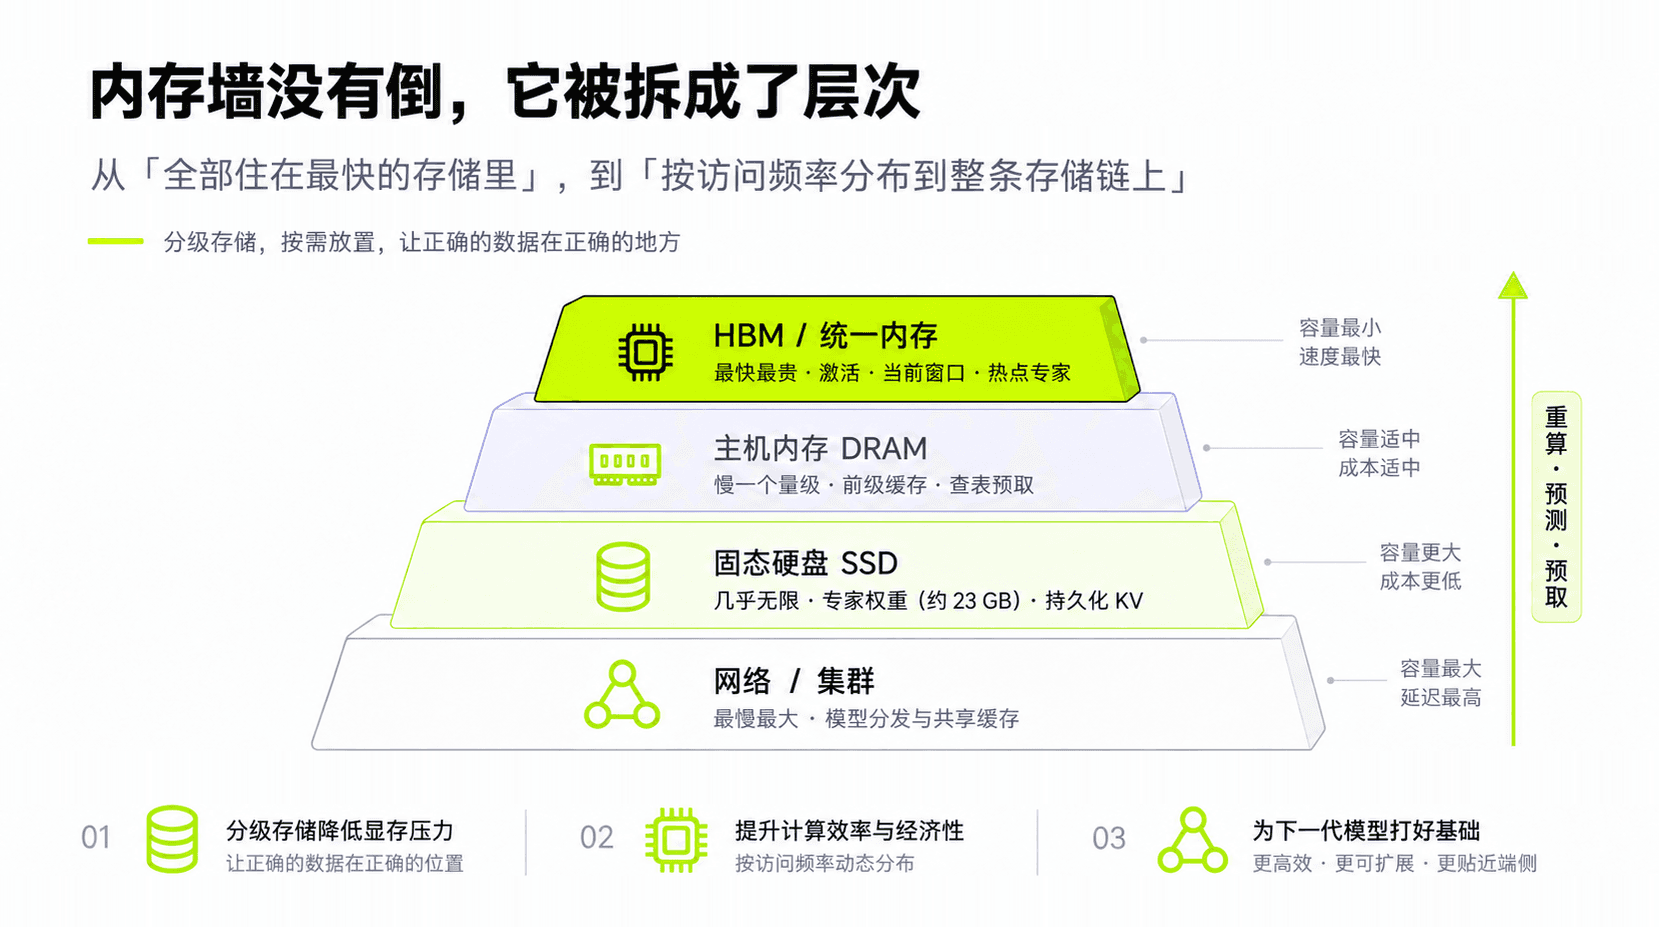
最快的存储里只留正在计算的那一部分。前缀缓存、跨轮复用的 KV、查表用的静态数据,放到主机内存。权重放到 SSD。模型分发和共享缓存交给网络。
这条线上最值得说的是 Engram(2026 年 1 月)。它把经典的 N-gram 查表现代化,让模型用「查」而不是「算」来取一部分知识,把一张 1000 亿参数的记忆表放在主机内存里,吞吐损失不到 3%。
它凭什么敢这么做?因为那张表的地址是算得出来的,所以可以提前取。这里藏着整条路线的前提条件:分层能不能成立,取决于访问是否可预测。
而这引出了这一代架构最反直觉的转向。过去,「访问是否可预测」是负载自己的属性——聊天有会话、文档有前缀,碰上了算运气好。现在它变成了模型可以自己设计出来的能力:索引器是可以训练的,哈希是确定性的,路由是有规律的。
换句话说,模型不只是在变小变快,它开始为存储系统让路。这是整条路线上最值得记住的变化:可预测性从一种运气,变成了一种可以训练出来的能力。
五、端侧:把两侧同时压到极限
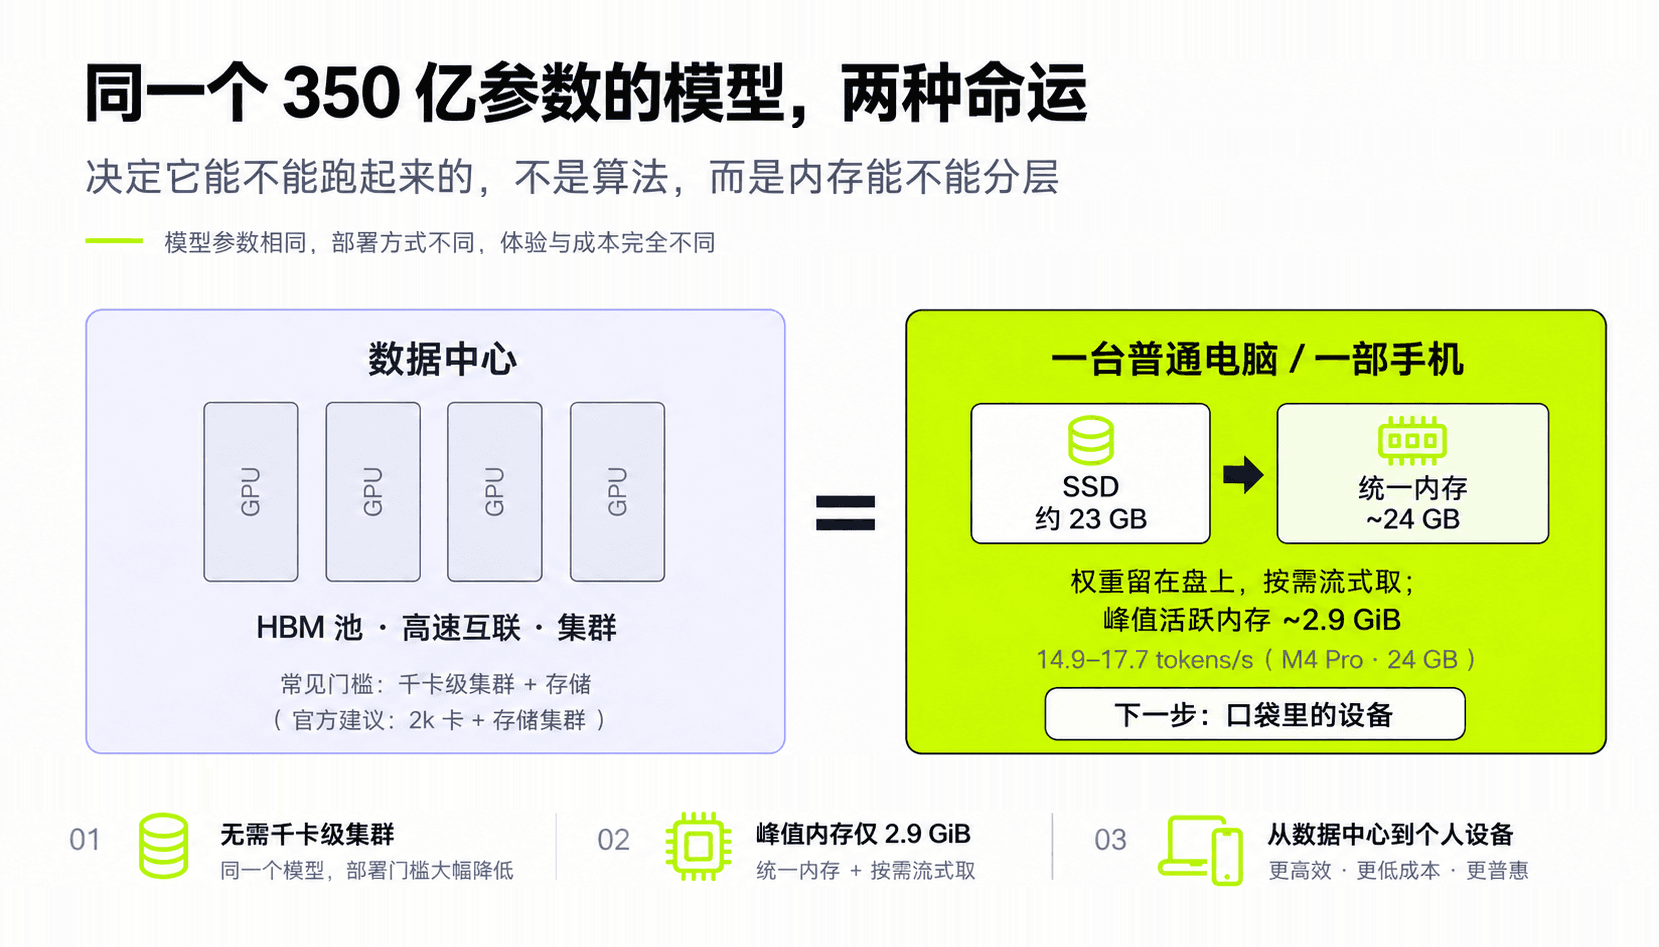
上面所有的分层,在机房里都有退路:带宽不够就加卡,内存不够就上集群。DeepSeek 在 V4.1 的发布说明里也写了,大规模部署需要 2000 卡级别的集群和存储集群。
端侧没有这些退路。一台 24GB 的电脑,或者一部手机,能用的只有机内那点内存和存储:没有高速互联,没有可扩展的存储池,连第二台机器都没有。
要在这种设备上跑一个 350 亿参数的模型,必须同时接受两件很别扭的事。
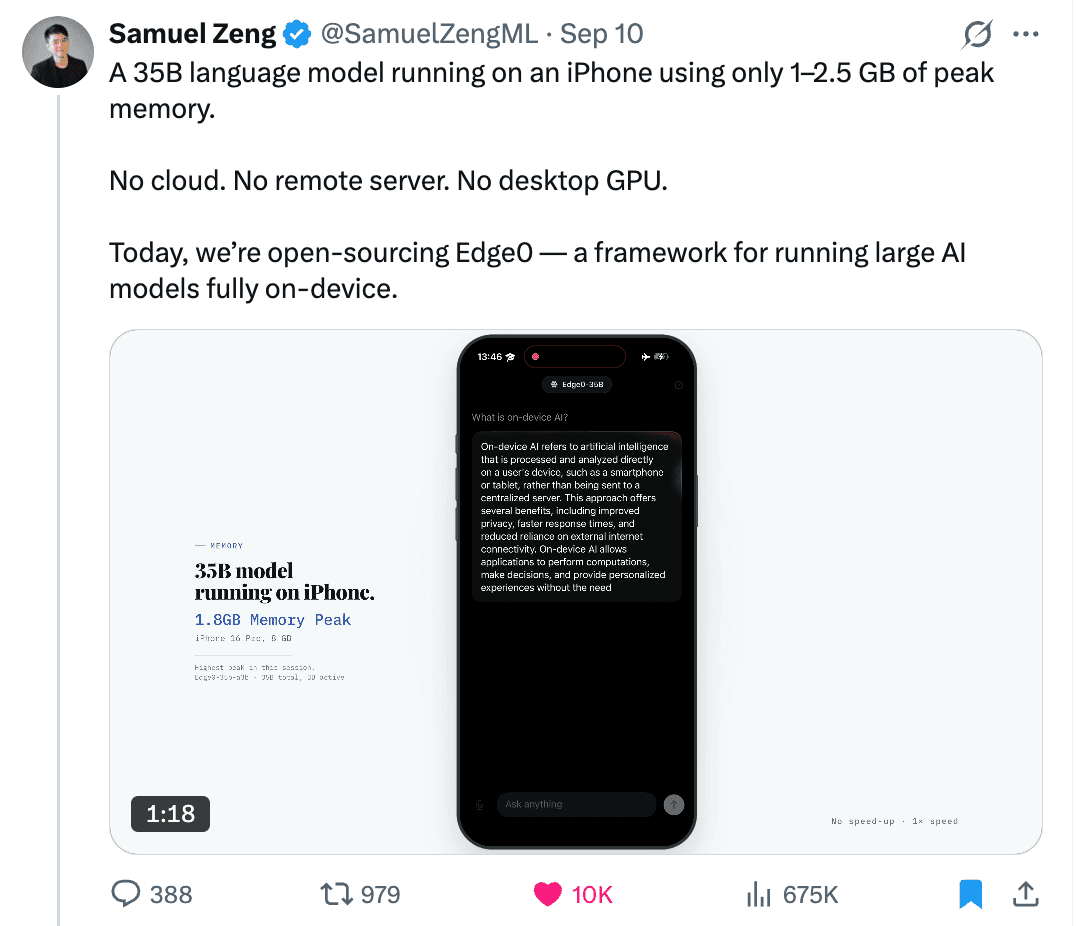
第一,认命:分层这条路走到端侧,就是让权重绝大多数时候不在内存里。我们的做法是 4bit 全量放在盘上(约 23 GB),按需流式读进来,峰值活跃内存压到 2.9 GiB这个量级,解码速度 14.9 到 17.7 tokens/s(一台 Mac mini,M4 Pro,24GB 统一内存)。
第二,不能等。从盘上读权重是有延迟的,而等待恰好发生在生成每一个字的必经路径上。一旦开始等,速度就没了。
状态那一侧同样躲不开。上面这个 2.9 GiB 是短上下文下的数字;上下文一长,它会跟着涨:3.3k token 的输入下,8b 档位的峰值活跃内存会到约 3.3 GiB,涨上去的那部分主要是 KV。两侧都得省,这正是端侧比机房难的地方。
而「不能等」这件事,逼着我们去回答一个在上面的故事里已经反复出现过的问题:怎么让访问变得可预测。
六、提前一步
模型在算第 N 层的时候,其实已经「知道」第 N+1 层大致需要哪些专家。路由不是随机的:同一段文字里,相邻层选中的专家重合度很高。
于是我们训了一组很小的头,让它在第 N 层就预测出第 N+1 层的路由,提前把权重从盘上取进来。装载和计算重叠,等待被藏到计算下面。这和 DSA 训练一个索引器、Engram 使用确定性哈希,是同一种工程直觉的不同实现:先把不确定的东西变成可预测的,再让硬件去追它。
预测并不是替模型做决定。发布的两档用的是显式索引——这一层实际计算哪几个专家,仍然由模型自己的路由决定,预测只负责提前把它们搬进内存。命中就直接算;万一没命中,就退回按需读取,慢一点,但结果一样。预测准确率影响的只是速度。
量化本身造成的精度损失,用另一条路补:冻结量化后的基座,用全精度模型做教师,蒸馏出一组低秩适配器,把掉下去的部分找回来。适配器不与基座合并,一份只读的基座可以服务多套适配器。对端侧来说,这意味着分发的体积可以小很多。
七、为什么我们关心它能不能跑到手机上
端侧不是性能最优解。它受限于磁盘带宽、电池和散热,能跑的模型规模永远比机房小;只看跑分的话,这场比较从一开始就不公平。
我们仍然想做,是因为它改变的不是性能的上限,而是谁能用上。这里有一个很具体的理由,不只是情怀。
算力是一种高度集中的资源。要跑前沿规模的模型,你通常需要千卡级的集群和一整套存储——这是官方给出的部署建议,没有夸张。算力必须集中,因为它需要机房、供电和高速互联。
但存储层次是分散的。每一台电脑、每一部手机里都有内存和闪存,只是过去它们不够快,也没人把那里当成「跑大模型的地方」。当瓶颈从算力转到字节数和访问模式,决定「能不能跑」的东西,就从一个组织拥有多大的机房,变成了一台设备的内存布局。
这就是「把大模型放到端侧」在技术上的分量:真正让模型平民化的,是内存角色的变化——从算力的附属品,变成普通设备也能管理的对象。
这件事为什么值得做,看看那些场景就清楚了。医院的病历、老师手里那几十份作文、小公司刚签下的合同、网络不稳的地方。「数据不能离开设备」和「模型能力不够强」是两个完全不同的问题,而前者在过去几乎没有解法。
每一次省下内存,也都在别处付了账:长程回忆会退化,训练要重做一遍,而同一个架构在不同推理引擎手里,能装下的上下文能差出三倍。所以「能省」和「省得起」是两件事,大多数团队卡在第二件。端侧把这两件事同时压到极限,这也是我们把它当成试炼场的原因。
端侧解决不了所有问题。它只是把门槛从「你有机房吗」,换成了「你手边有什么设备」。
一台两年前的笔记本,一部手机,就够开始。
本文作者:林宇(无界方舟首席科学家)、曾晓东(无界方舟CEO)
参考资料
- W. A. Wulf, S. A. McKee. Hitting the Memory Wall: Implications of the Obvious. ACM SIGARCH Computer Architecture News, 23(1), 1995.
- Character.AI. Optimizing AI Inference at Character.AI(Part Deux), 2024-06.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA). arXiv:2405.04434, 2024-05.
- DeepSeek-AI. DeepSeek-V3.2-Exp 发布说明(DSA 稀疏注意力), 2025-09.
- DeepSeek-AI. DeepSeek-V4 / V4.1-Flash 发布说明(含 1/4 KV、1/8 落盘缓存口径), 2026.
- Engram: Conditional Memory via Scalable Lookup. arXiv:2601.07372, 2026-01.
- Together AI. DeepSeek-V4 推理服务工程复盘(SWA 状态保留与单节点上下文容量), 2026.
- Mamba-2: Transformers are SSMs. arXiv:2405.21060, 2024-05;Kimi Linear: An Expressive, Efficient Attention Architecture(KDA), 2025-10.