Audio8-ASR-3B:高精度语音识别旗舰
Audio8-ASR 家族 · 3B 大模型
2026 年 09 月 10 日
从声音到文字Audio8-ASR / Audio8-ASR-3B
同样是语音识别,有些场景“听个大概”就够了,有些场景却一个字都不能错。Audio8-ASR-3B 面向会议记录、访谈整理、媒体字幕和多语言混合等“听错代价很高”的场合,把最大的参数量留给最难听清的声音。
它与家族成员共享同一套识别目标,但在复杂噪声、远场拾音、多人对话和长音频场景中提供最强的质量余量。
| 项目 | 信息 |
|---|
| 模型名称 | Audio8-ASR-3B |
| 参数量级 | 3B 参数 |
| 定位 | 高精度旗舰,攻坚最复杂的声音 |
| 主要运行环境 | 高性能 GPU / 云端服务 |
| 语言支持 | 19 种语言 |
| 适合的任务 | 复杂噪声、多语言、长音频与高质量转写 |
核心能力:在嘈杂世界里,它听得最清楚
Audio8-ASR-3B 将识别能力集中在真实录音环境:会议室风扇与键盘声、活动现场回声、多人同时开口,以及被拉远的麦克风,都能保持稳定转写。
| 特点 | 带来的好处 |
|---|
| 19 种语言覆盖 | 一个模型服务多语言业务,无需为每种语言单独部署 |
| 大上下文窗口 | 整场会议或整期播客一次转写,前后内容保持连贯 |
| 多语言统一建模 | 中英混合、多语种混说的句子也能自然转写 |
| 稳定一致的输出 | 适合质检、字幕、检索等下游流程 |
持续霸榜的识别性能
在中文 CER、英文 WER 与多语言公开评测中,Audio8-ASR-3B 持续保持领先;噪声、远场、口音和多人对话下的稳定性,让它可以直接作为高要求业务底座。
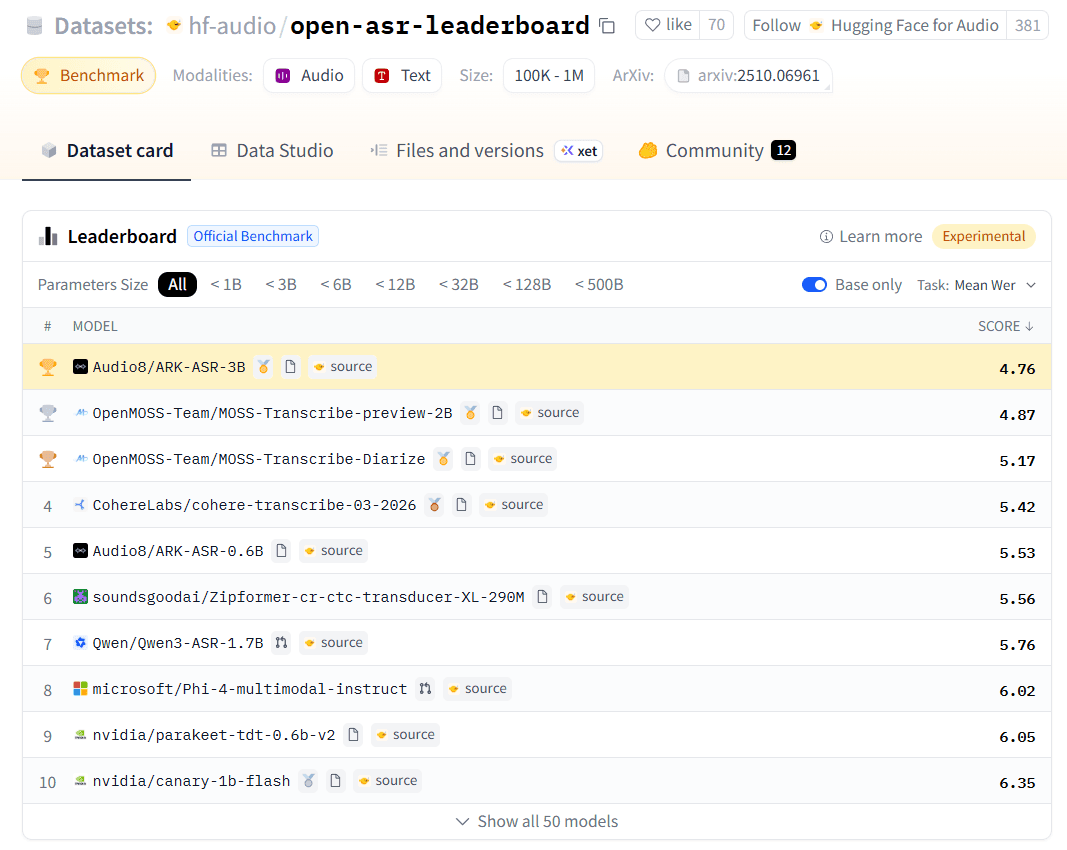 Audio8-ASR 家族公开评测表现(数据截至 2026 年 9 月 4 日)。
适用场景与快速上手
适合会议与访谈转写、媒体字幕、专业术语识别和需要高质量批量处理的云端服务。选择 GPU 运行时,接入转写 API,再将结果交给现有审核或检索流程即可。
家族一览
如果部署预算更紧,可选择 0.6B;如果必须在手机或边缘设备本地运行,则应评估 0.1B 系列。
边界与负责任使用
自动转写可能受噪声、口音、重叠语音、专有名词和音频质量影响,不应作为未经复核的事实记录。医疗、法律、金融等高风险场景必须经人工审核,部署方应对最终输出负责。
处理个人声音、谈话内容或敏感信息时应依法取得授权并遵守《个人信息保护法》、GDPR 等法规,音频与文本需妥善加密、限权与限期存储。
Audio8-ASR-3B / Audio8-ASR
把“听懂声音”落实到目标设备,让识别质量与部署成本同时成立。