高保真、多语言、零样本语音生成。参考录音只需提供一次,新的文本可以自由变化,甚至可以切换语言,而声音身份仍然清晰可辨。
Audio8-TTS-0.6B 是一款面向高保真、多语言零样本语音生成的模型。参考录音只需提供一次,新的文本可以自由变化,甚至可以切换语言,而声音身份仍然清晰可辨。
主模型包含 601,159,424 个参数,不计随模型提供的神经音频编解码器。它适合在 GPU 服务中运行,并通过 SGLang Omni 支持分页注意力、动态批处理、参考音频编码、波形解码和 OpenAI 兼容的语音接口。
DualAR:把语义和声学细节拆开
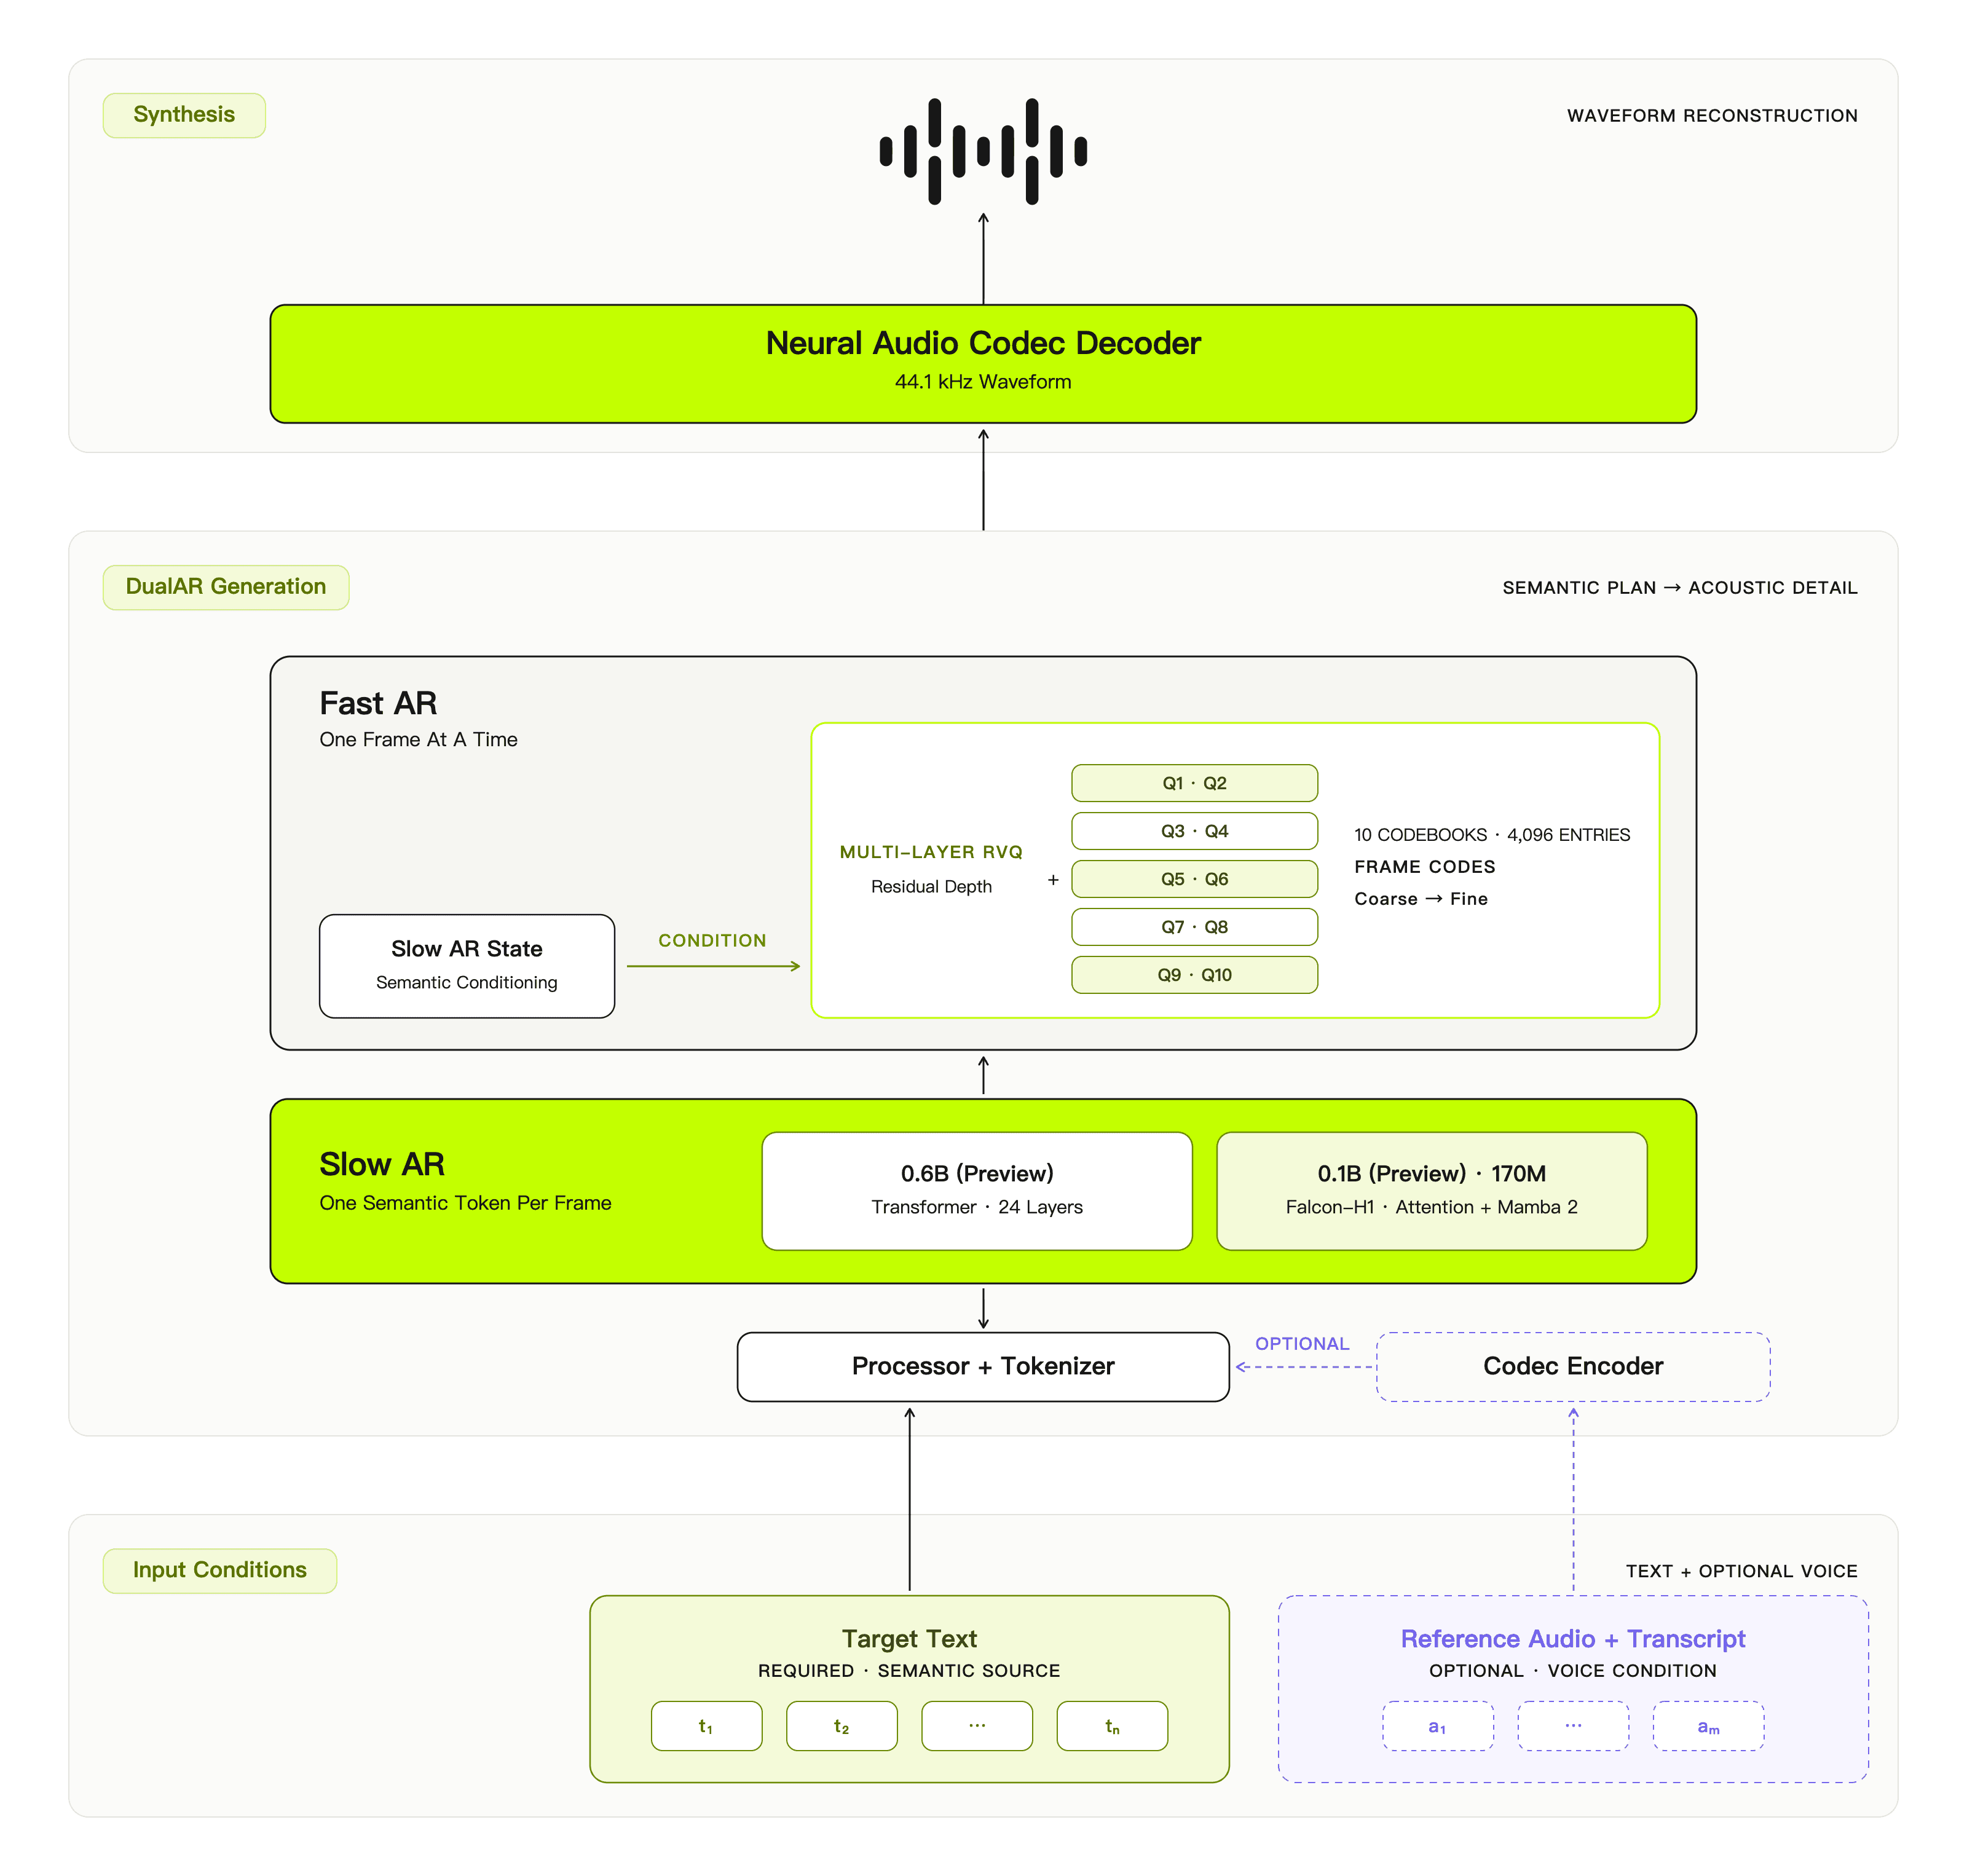
一句语音同时受两个时间尺度支配。Slow AR 每个 codec frame 推进一个语义 token,决定文本对齐、停顿和句子的整体走向;Fast AR 读取 Slow AR 的隐藏状态,在当前帧内沿 RVQ 深度填充声学码本。两个分支职责不同,长程结构和局部保真不必争夺同一条 token 序列。
配置与多层 RVQ
| 组件 | 配置 |
|---|
| Slow AR | 24 层 Transformer,宽度 896,14 个注意力头,2 个 KV 头 |
| Fast AR | 4 层 Transformer,宽度 896,14 个注意力头,2 个 KV 头 |
| 声学表示 | 10 个码本,每个码本 4,096 个条目 |
| 神经编解码器 | 44.1 kHz,每个模型帧 2,048 个采样点 |
| 帧率 / 上下文 | 约 21.5 帧/秒;最多 2,048 个打包后的文本/音频位置 |
2,048 个采样点约对应 46.4 ms。Slow AR 每秒做约 21.5 次语义决策,Fast AR 再为每个决策填入 10 层残差信息。前几个码本建立粗略结构,后几个码本补充音色、咬字和频谱纹理;这种按深度分配的 token 预算,是 DualAR 能够兼顾连贯性和细节的关键。
从一个参考声音开始
零样本克隆不要求为每位说话人重新微调模型。系统把短参考录音与准确转写一起编码,生成新的目标文本时再把这对条件送入 DualAR。参考文本是条件的一部分,而不是录音旁边的备注;录音干净、文本准确时,通常能获得最稳定的结果。
正在加载精选试听集……
多语言与跨语言
0.6B 覆盖中文、荷兰语、英语、法语、德语、意大利语、日语、韩语、波兰语、粤语和西班牙语。中文参考录音可以引导英文语句,英文参考录音也可以引导中文,文本的语言发生变化,声音锚点却始终不动。
紧凑规模下的 SOTA-class 表现
在公开的 Seed-TTS 与 CV3 对比中,0.6B 是参与比较的最小主模型之一,同时在英语 WER、中文 CER 和多语言错误率上处于第一梯队,展现出 SOTA-class 的竞争力。不同项目的测试集和归一化方式并不完全相同,结果应作为公开结果的参考。
| 评测 | 公开结果 |
|---|
| Seed-TTS | EN 1.506 WER / 63.2 SIM;ZH 0.950 CER / 73.1 SIM |
| CV3 | ZH 3.205;EN 3.128;Hard-ZH 10.535 |
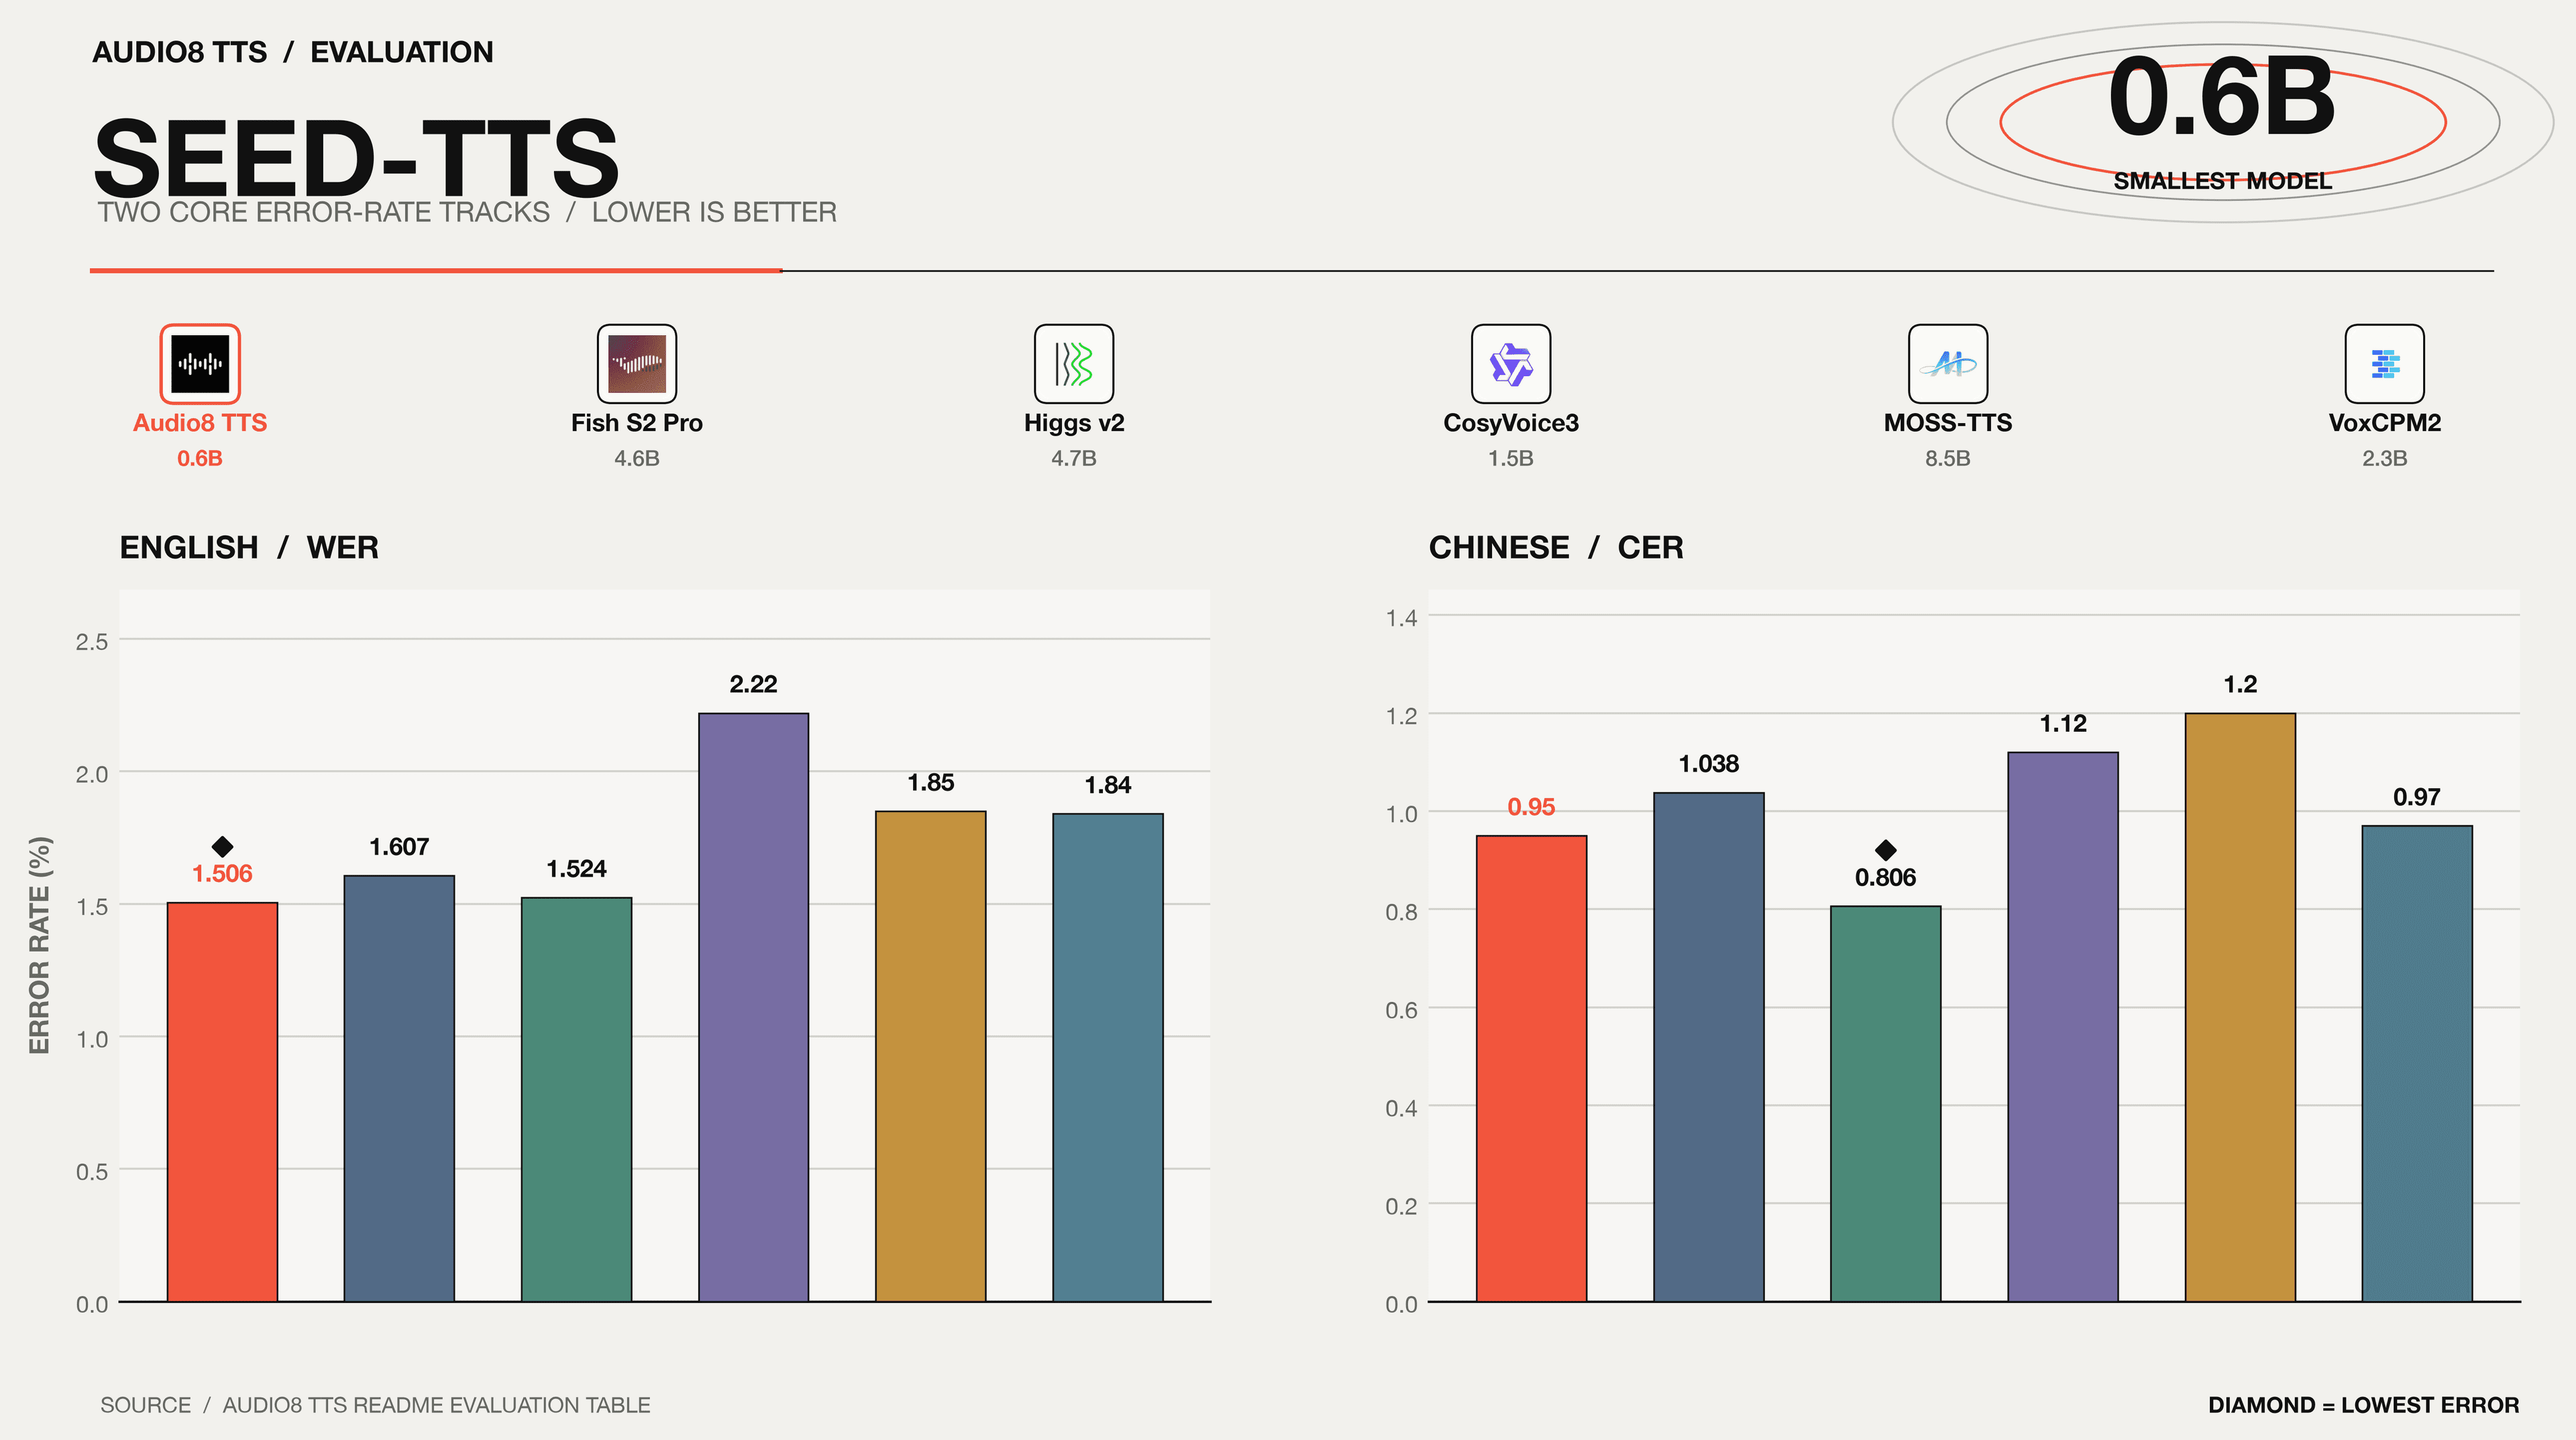 Seed-TTS:WER/CER 越低越好,SIM 越高越好。
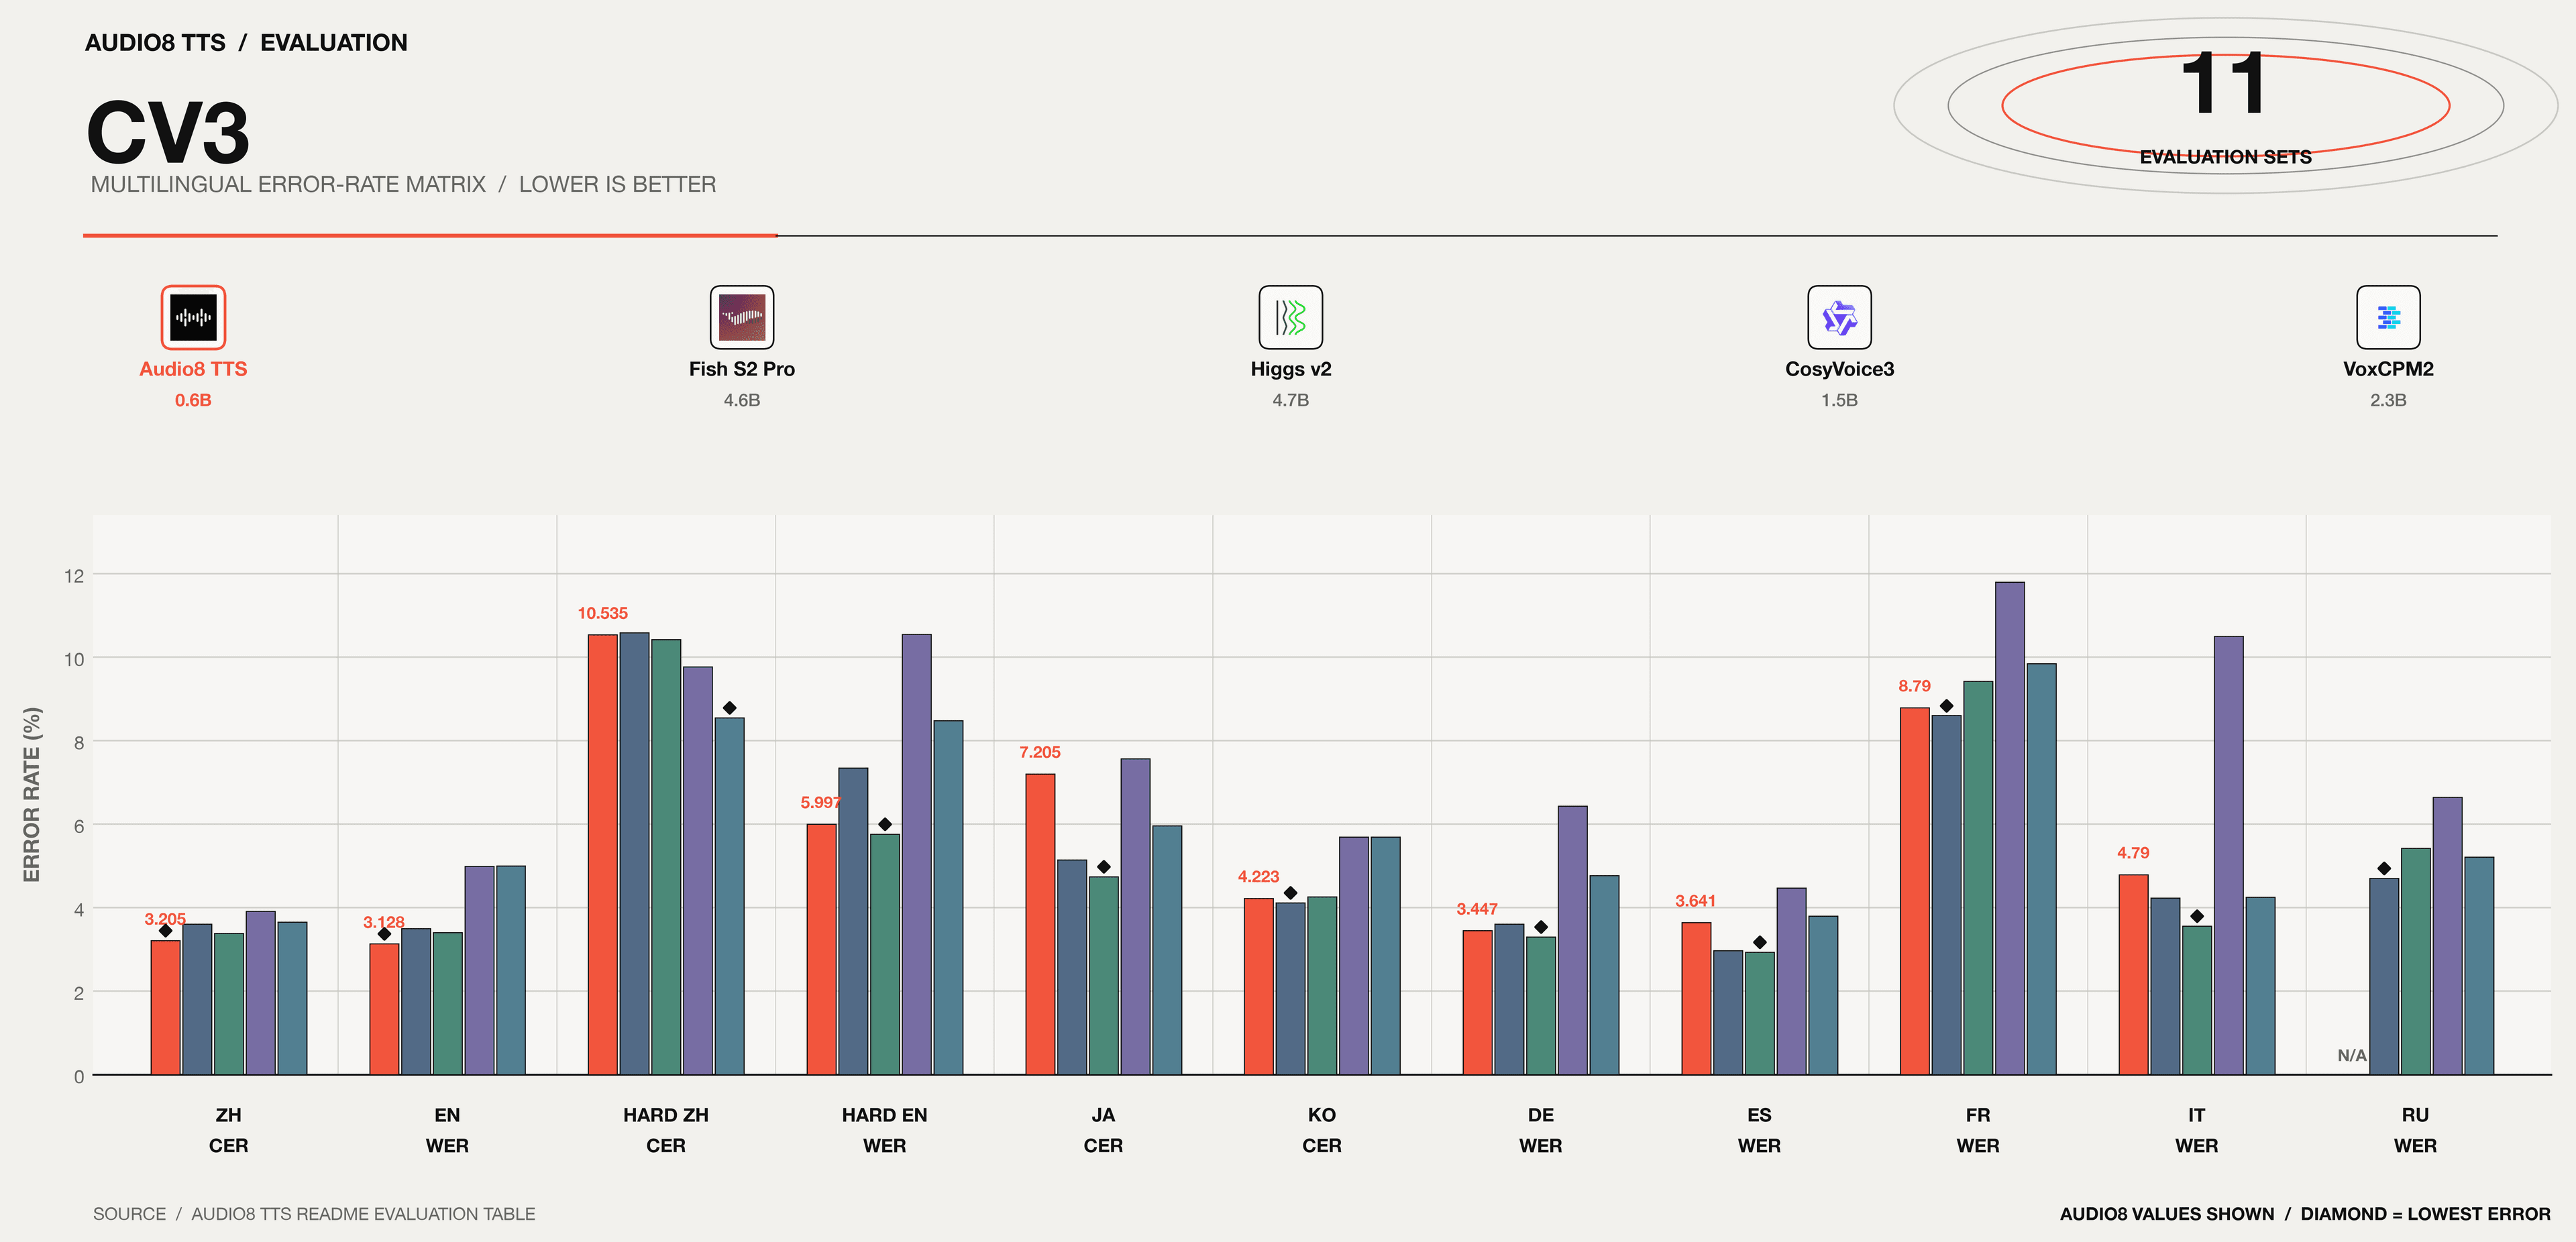 CV3:公开多语言错误率对比。
Audio8 仓库提供 SGLang Omni 适配器,支持分页注意力、动态批处理、参考音频编码、波形解码,以及兼容 OpenAI 格式的 /v1/audio/speech 接口。单张 NVIDIA H20 的 warm 单流测试中,生成 128 帧的 p50 延迟为 0.691 s,RTF 为 0.116;测试不包含冷启动和编译时间。